

Ano ang AI Model Distillation Attacks? Paano nila pinoprotektahan si Claude ng Anthropic
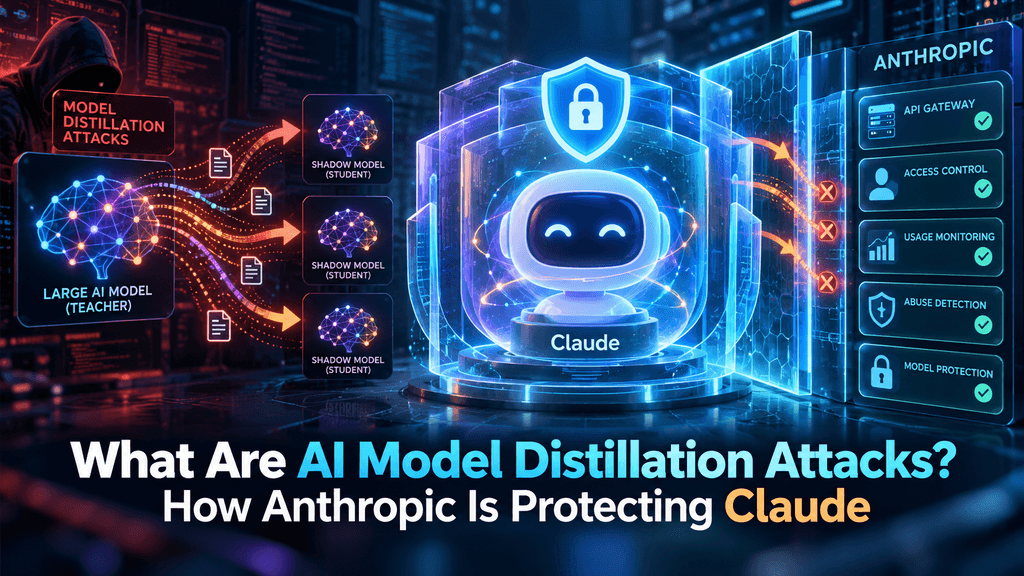
Maaari ba ang milyon-milyong dolyar sa propiyetaryong panelitian sa artificial intelligence na ma-siphon lamang sa pamamagitan ng pag-query sa isang pampublikong API? Ang mga pag-atake sa model distillation ay nagpapahintulot sa mga mapanlinlang na entidad na sistematikong mag-query sa mga frontier system tulad ng Claude upang makalap ng mga mataas na densidad na mga daan ng pag-iisip, mga function schema, at panloob na lohika upang turuan ang mga kalaban na sistema sa isang maliit na bahagdan ng karaniwang budget sa pag-unlad. Sa loob ng mga decentralized physical infrastructure networks (DePIN) at cryptocurrency ecosystem, direktang pinapanganib ng banta na ito ang mga decentralized compute pools, mga open-weight intelligence markets, at autonomous agent infrastructure. Sa pamamagitan ng pag-clone ng mga frontier capability, ang mga kalaban ay nagpapababa sa mga tokenized network at mga smart contract safety tools nang walang pagsuporta sa pangunahing panelitian. Ang Anthropic ay tumugon sa banta na ito sa pamamagitan ng pag-deploy ng mga multi-tiered classification systems, automated behavioral clustering, output watermarking, at dynamic inference adjustments. Ang pagsusuri na ito ay tumatalakay sa mekanika ng distillation attacks, ang kanilang malubhang epekto sa decentralized AI markets, at ang multi-layered defense architecture ng Anthropic.
Mga Pangunahing Aral
-
Pangunahang Konsepto: Ang mga pag-atake sa model distillation ay nagpapahintulot sa mga attacker na gamitin ang mga publikong interface ng inference upang lumikha ng mga malalim na sintetikong corpus, na nagpapahintulot sa kanila na kopyahin ang propiyetaryong pag-iisip na pag-uugali habang iiwasan ang mga gastos sa pagsisiyasat.
-
Mga Vulnerabilidad sa Web3: Ang mga ecosystem ng decentralized AI, autonomous na on-chain bots, at mga tokenized na compute network ay nakakaranas ng malalaking struktural na panganib kapag ang hindi pinahintulutang distillation ay nagiging komodidad sa mga natatanging kakayahan ng modelo.
-
Mga pagsuporta ni Anthropic: Ang mga mekanismo ng depensa ay kasama ang real-time pag-analisa ng intensyon, multi-tenant behavioral telemetry, pagprotekta sa kontekstwal na pag-iisip, at cryptographic token watermarking.
-
Sybil-Driven API Exploitation: Ang mga kampanya ng pagkuha ay gumagamit ng mga decentralized proxy ring, pagbabago ng mga virtual na payment channel, at pseudonymous na cryptocurrency rails upang itago ang malawakang pagkuha bilang organic na trapiko ng user.
-
Pagbabago ng Ekonomiya ng Merkado: Ang mga matibay na depensa ay nagtatanggal ng mga madaling paraan ng pagkopya, nagpupilit sa mga developer sa tradisyonal na teknolohiya at Web3 sectors na mag-invest diretso sa mga autentikong pangunahing dataset at verifiable inference.
Ano ang AI Model Distillation Attacks?
Ang Mekanika: Paano ginagamit ng pag-extract ang mga interface ng model
Ang mga pag-atake sa model distillation ay gumagamit ng karaniwang API access upang makalap ng proprietary na ari-arian sa kaalaman at kopyahin ang mga advanced na kakayahan. Ang paggawa ng frontier models ay nangangailangan ng mga milyon-milyong dolyar sa nakalaang hardware clusters, pinabuting synthetic pipelines, at malawakang reinforcement learning. Sa kabaligtaran, ang isang attacker ay nagpapagsimula ng automated query batches sa mga espesyalisadong domain, nagkukuha ng komprehensibong output ng target model, at ginagamit ang structured na materyal na iyon upang i-fine-tune ang mas maliit, open-weight architectures. Ang prosesong ito ay naglalaktaw sa mga hadlang sa kapital at inhenyeriya na nagtataglay ng modernong pag-unlad ng machine learning.
Ang pag-atake ay nakatutok sa mga standard na interface ng text-generation. Dahil ang mga advanced na sistema ay disenyo upang magbigay ng malinaw, kompletong pagbabalangkas ng problema kapag sumasagot sa mga prompt tungkol sa programming o matematika, sila ay hindi inaasahang naglalabas ng eksaktong mga signal na instruksyon na kailangan upang ituro ang mga imitation model. Ang attacker ay nagpapadala ng mga kumplikadong lohikal na hamon, nag-uugnay ng mga intermediate na hakbang sa pag-iisip, at nagtatagpo ng isang malalim na corpus para sa pagtuturo. Kapag kinain ng isang mas maliit na recipient model, ang curated na data na ito ay nagpapahintulot sa imitation system na makamit ang parehong benchmark scores habang ginagamit ang mas mababa sa isang porsyento ng orihinal na kapital sa pagtuturo. Dahil ang mga query ay tila mga legal na hiling mula sa developer, ang tradisyonal na mga pagsisigla sa perimeter ay hindi makakakilala sa pagkuha.
Paggamit ng Sintetikong Data at Pagkuha ng Pag-iisip
Ang pagkuha ng mga intermediate reasoning traces ay nagpapabilis nang malaki ang imitation learning kumpara sa standard unsupervised pretraining. Ang mga attacker ay nakatuon sa mga mataas na leverage na domain tulad ng automated smart contract auditing, game-theoretic negotiation, decentralized exchange arbitrage, at symbolic mathematics. Sa pamamagitan ng pagsumbong ng mga prompt na inayos upang pilitin ang step-by-step na lohika, ang kalaban ay nagko-convert sa target platform bilang automated dataset generator.
-
Chain-of-Thought Harvesting: Paggawa ng mga hakbang sa paglutas ng problema upang makuha ang mga proseso ng pag-iisip at i-transfer sa mga network ng mga tagatanggap na hindi nakakasundo o walang pahintulot.
-
Paggamit ng Tool at Pagkakawala ng Schema: Pagkuha ng mga istruktura ng pagtawag sa function, structured JSON outputs, at mga prosedurang pagbabalik upang ituro ang mga autonomous execution agents.
-
Pagsusuri sa Safety Boundary: Sistematisang pag-evaluate ng mga guardrail upang ma-mapa ang mga filter ng moderation at ituro ang secondary models na makakalabas sa standard na alignment protocols.
Mga Topolohiya ng Pag-atake: Mga Kampanya ng Distributed Extraction
Gumagamit ang modernong distillation campaigns ng distributed infrastructure kaysa sa mga isolated client upang maiwasan ang rate limiting batay sa volume. Batay ang mga operasyong ito sa proxy pools, rotating identity profiles, at multi-tenant hosting upang maging katulad ng mga iba’t ibang pattern ng retail interaction.
| Attack Vector | Mekanismo ng Pag-deploy | Layunin na Aset | Komplikasyon ng Pagdetekta |
| Coordinated Query Pools | Distributed botnets na nagpapalit-palit ng mga client access key | Mga malalim na matematikal na patunay, lohika ng smart contract | mataas |
| Mga Simuladong Retail Prompt | Mga paraphrased na bersyon ng mga pamantayang akademiko | Espesyalisadong kaalaman sa institusyonal na domain | Sangat Mataas |
| Mga Loop ng Autonomous Agent | Mga self-prompting na pipeline na nagpapatakbo ng mga multi-step na trabaho | Mga iskema ng pagpapatupad, real-time na pagkorekta ng mga error | Extreme |
| Adversarial Border Scans | Automated na pagsubok ng mga hangganan ng guardrail | Mga limitasyon sa operasyonal na kaligtasan, mga batayang pagpapalakas | Moderado |
Madalas na ginagamit ng mga distributed network ang cryptocurrency rails upang panatilihin ang kahalintulad na pagkakakilanlan. Ang mga attacker ay pinapagana ang mga access key gamit ang mga virtual payment provider na pinagmumulan ng decentralized assets, na nagpapabagsak sa mga link ng pag-verify ng identity na ginagamit ng mga enterprise cloud platform. Bilang resulta, ang mga extraction campaign ay nagiging bahagi ng normal na paglago ng trapiko kaysa maging makikita bilang mga pinagsasamang operasyon.
Pagsasalubong sa Web3 at Cryptocurrency
Mga Banta Laban sa DePIN at Decentralized Compute
Ang model distillation ay nagdudulot ng agad na ekonomikong hamon sa mga Web3 artificial intelligence network at decentralized physical infrastructure systems. Ang mga DePIN network ay nagko-coordinate ng mga distributed hardware cluster upang turuan, suriin, at host ang mga model sa pamamagitan ng token incentives. Kapag ang mga model na host sa mga open node ay sistematikong isinusukat sa pamamagitan ng hindi awtorisadong distillation, bumababa ang intrinsic value na sumusuporta sa mga native utility tokens.
Kung ang pag-access sa mga node ng decentralized model ay nagbibigay ng sariling-hosted lokal na kopya, bumababa ang pangangailangan para sa native staking at utility tokens. Ang distillation ay nagiging komodidad sa mga computational output bago makamit ng mga network ang patuloy na kita mula sa mga bayad. Halimbawa, kung ang isang ecosystem ay gumagastos ng pondo mula sa treasury upang buuin ang isang espesyalisadong blockchain analytics engine, maaaring kuhanin ng isang kalaban ang mga kakayahan sa pag-iisip na iyon sa loob ng ilang araw, i-deploy ang parehong model sa isang alternatibong network, mabawasan ang presyo, at palaguin ang posisyon sa merkado ng orihinal na proyekto.
Mga vulnerabilities sa mga Smart Contract Agent at On-Chain Security
Mga autonomous agent na gumagamit ng frontier models para sa yield optimization, liquidity management, at smart contract evaluation ay nakakaranas ng malubhang operasyonal na duplicasyon. Ang mga kalaban ay nagmomonitor sa mga gawain ng agent upang hiwalayin ang mga estratehiya sa pagpapatupad, mga parameter ng panganib, at mga mekanismo ng pagpapatotoo.
-
Pagsasalin ng Estratehiya: Ang mga kalaban ay nagpapakopya ng mga autonomous market-making algorithm sa pamamagitan ng pagkuha ng mga frame ng desisyon na nilikha ng mga agent na hinahamon ng harap.
-
Pagpapabilis ng pagpapabaya: Ang mga cloned na modelo na tinuturuan sa mga extracted na security heuristics ay nagpapahintulot sa mga kalaban na magagawa ang offline vulnerability scans, at makahanap ng mga kakulangan sa contract nang hindi ipapalabas ang aktibidad sa mga public ledger.
-
Mga Sybil Funding Loops: Ang mga hindi reguladong entidad ay gumagamit ng mga wallet na nakatuon sa privacy at mga de sentralisadong financial tool upang pagsanayin ang mga scraping cluster, at iwasan ang mga pagsusuri ng know-your-customer.
Staking na Pagkabigo sa Decentralized Machine Learning
Ang ekonomikong seguridad ng mga staked AI network ay nakabatay sa prinsipyo na ang pagbuo ng mataas-kalidad na intelligence ay nangangailangan ng malaking gastos sa mga yaman. Sa isang proof-of-stake machine learning setup, ang mga operator ng node ay naglalagay ng collateral upang jaminan ang akurat at computationally intensive na mga output.
Ang distilasyon ay nagpapabagsak sa balanseng insentibo. Maaaring distilahin ng isang masasamang operator ang isang proprietary na modelo sa isang magaan na imitasyon na arkitektura, ipaalam ang kopya sa murang consumer hardware, at ipasa ang mga output nito sa network. Dahil tumutugma ang imitasyon sa mga pamantayang pagpapatotoo, kumikita ang operator ng buong mga reward sa pagpapatotoo habang nagdadala ng isang maliit na bahagi ng mga gastos sa legitimo na compute. Ang dinamikang ito ay nagpaparusá sa mga tapat na operator na nagpapanatili ng dedikadong enterprise infrastructure, at nagpapalakas ng sentralisasyon ng network at pagbaba ng tiwala sa decentralized protocol.
Paano pinoprotektahan ni Anthropic ang Claude
Dinamikong Dalawang-Stage na Pagkaklasipikasyon ng Intensyon
Ginagamit ng Anthropic ang isang dalawang-saklaw na klasiipikasyon na framework upang harapin ang mga query sa pagkuha bago ito magkaroon ng training data. Sa halip na mag-asa sa mga simpleng blacklist ng mga salita, sinusuri ang mga kahilingan sa mga dimensyon ng semantiko, sintaksis, at istruktura.
Ang unang yugto ay nagpapagawa ng structural semantic profiling. Tinataya ng classifier kung ang isang dumadating na prompt ay nagpapakita ng mga tanda ng programmatic dataset generation—tulad ng paulit-ulit na permutations o akademikong benchmark structures—kaysa sa organic na paggamit ng developer. Ang pangalawang yugto ay nagmomonitor ng output token emission dynamics sa real time upang pigilan ang mga query na disenyo upang kuhanin ang mga nakatago na pag-iisip. Kapag natutukoy ang mataas na posibilidad ng pagkuha, tinatawag ng platform ang dynamic response adjustments, nagbibigay ng direkta sagot habang iniiwasan ang mga intermediate reasoning traces na kailangan ng mga attacker para sa fine-tuning.
Multi-Tenant Behavioral Telemetry at Clustering
Upang maipakita ang mga distributed client rings, kinokorrelasyon ng Anthropic ang behavioral telemetry sa mga tila independiyenteng user account. Dahil nangangailangan ang distillation ng malalaking volumen ng data, ang mga harvesting campaign ay nagpapagawa ng makikita na statistical correlations sa buong network.
Kapag nagpapakita ang mga magkakaibang account sa iba’t ibang IP spaces at payment method ng paralel na mga pag-uugali, tinatanggal ng platform ang ugnayan. Tinataya ng telemetry engine ang pagkakatulad ng mga template ng prompt syntax, mga sinkronisadong token request, at komplementarong pagpapalawak ng domain. Kung libu-libong magkakaibang account ang nagtatanong ng mga variations ng mga parehong programming challenges sa mga naka-iskedyul na sequence, iginagawad ng sistema ang mga ito sa isang pinagsasamang operasyon. Pagkatapos ay ipinapasa ni Anthropic ang mga pinagsasamang pagbabawas sa rate, detalyadong logging, at pagpapahinto sa parehong pag-access upang burahin ang network.
Proteksyon sa Context-Window
Ang isang itinatag na paraan ng distilasyon ay naglalayon sa pagmanipula ng konteksto, kung saan ang mga attacker ay nagpapaste ng mga nakaraang hakbang ng pag-iisip ng modelo pabalik sa mga bagong prompt upang pilitin ang patuloy na paglalabas ng teknikal na impormasyon.
Nilikha ng Anthropic ang vulnerability na ito sa pamamagitan ng pagbabago sa mekanismo ng pagproseso ng konteksto. Ang sistema ay nagpapatupad ng mahigpit na pagsubaybay ng pinagmulan para sa lahat ng mga token sa loob ng window ng konteksto, na nagkakaiba sa panlabas na input ng user, nakaraang kasaysayan ng pagbuo, at mga protektadong elemento ng pag-iisip. Kapag inilalagay ng user ang mga nakaraang nabuong trace ng pag-iisip upang pilitin ang sistematisadong paglalabas, kilala ng modelo ang adversarial na pattern at tinatapos ang execution path, binabawalan ang paggamit ng malalaking window ng konteksto bilang mga vector ng pagkuha.
Cryptographic at Statistical Output Watermarking
Ginagamit ng Anthropic ang statistical watermarking upang mag-imbak ng verifiable structural patterns sa loob ng mga output sequence, nagbibigay ng matematikal na ebidensya ng pinagmulan nang hindi nakakasira ng kalinawan, kagalingan, o teknikal na katumpakan.
Ang pangunahang teknik ay gumagamit ng mga pagpapalit ng frekwensiya ng pseudorandom token. Ang generation engine ay may maliliit na pagpapabuti sa mga partikular na magkakasalungat na token batay sa isang panloob na cryptographic key. Habang ang output ay tila natural sa mga reader, ang statistical analysis ng malalaking dataset na ginawa ng isang apektadong clone model ay nagpapakita kung ito ay tinuruan sa mga output ng Claude. Ang pagtukoy sa pinagmulan ay nagbibigay ng actionable ebidensya upang hikayatin ang mga klaim sa ari-arian, tanggalin ang hindi awtorisadong model mula sa mga open repository, at i-invalid ang ilegitimong serbisyo sa mga decentralized network.
Mga Pagsasagip sa Ekonomiya
Ang pinakamalakas na depensa laban sa model distillation ay nagpapabagsak sa mga pagsusuri sa pananalapi ng attacker. Ang distillation ay maaaring gawin lamang kung ang pag-query sa isang API ay mas mura kaysa sa pagbuo ng sariling modelo. Pinagsasama ng Anthropic ang teknikal na depensa kasama ang ekonomikong parusa.
| Protective Layer | Operasyonal na Pagpupuno | Stratehikong Resulta |
| Dalawang-Stage na Classifier | Real-time na semantic analysis | Nagpapalit ng mga prompt para sa pagkuha bago ang pag-generate |
| Behavioral Clustering | Cross-account pattern correlation | Nagpapalit ng distributed scraping botnets |
| Proteksyon ng Konteksto | Pagsusuri sa pinagmulan ng token | Nagpapahiging sa pagkuha ng prompt-injection |
| Mga Statistical Watermarks | Mga pagpapalit sa kalasag ng kriptograpikong token | Nagbibigay ng verifiable na pagkilala sa nasupil na data |
Kapag natutukoy ng mga intent classifier ang isang pagtatangka ng pag-extract at lumilipat sa mga maikling output, proseso ng platform ang request sa standard na rates ng pagbabayad. Dagdag pa, kapag pinatotohanan ng behavioral fingerprinting ang isang distributed extraction ring, tinatapos ang mga kaugnay na account at nawawala ang pre-funded balances dahil sa paglabag sa serbisyo. Ang pagbabayad para sa hindi viable na training data habang ina-neutralize ang mga operasyonal na account ay ginagawa ang malawakang pag-extract na ekonomikong hindi maaari.
Mga Estratehikong Epekto sa Mga Merkado ng Crypto at AI
Pagbabago sa Ekonomiks ng Machine Learning
Ang pag-deploy ng epektibong mga depensa laban sa distilasyon ay nagbabago sa unit economics ng pag-unlad ng AI sa parehong tradisyonal na computing at decentralized protocols. Habang hinahawakan ng mga frontier platform ang mga synthetic training leaks, muli nang nangangailangan ang pagbuo ng performant na mga model ng tunay na computational capacity, arkitekturang inobasyon, at mga verified na dataset.
Ang transisyong ito ay pinapabilis ang pagkonsolidad ng kapital sa mga protokolo ng decentralizadong intelihensya. Hindi na makakapagpapanatili ng mga koponan ng mga halaga sa pamamagitan ng pagpapakita ng mga pinagbawasan na output sa mga bukas na wrapper. Dapat mag-invest ang mga decentralizadong inisyatiba sa pangunahing pananaliksik, cryptographically verified na tao feedback, at dedikadong imprastruktura. Ang mga merkado ng digital na aset ay nagpapakita ng pagbabagong ito, at nagre-reallocate ng kapital mula sa mga derivative wrapper patungo sa mga pangunahing protokolo na nagpapakita ng patotohanang katotohanan sa pagtuturo at mapanatiling arkitektura ng modelo.
Pagsisiguro ng mga Open-Weight Ecosystem
Ang hangganan sa pagitan ng open-source na pananaliksik at propiyetaryong intelihensya ay tinutukoy kung paano pinag-uugnay ang pinagmulan ng data. Ang mga open-weight na modelo na tinuturuan sa mga napatunayan at pampublikong dataset ay nananatiling mahalaga para sa mga transparent at de sentralisadong sistema. Gayunpaman, ang mga sistema na nakasalalay sa hindi awtorisadong distilasyon ay nakakaranas ng biglaang pagkabigo dahil sa mga pagtutol sa antas ng platform at mga responsibilidad sa regulasyon.
Ang mga organisasyon sa Web3 na nagtatagpo ng machine learning at blockchain rails ay dapat bumuo ng mga verifiable na data pipeline. Ang pag-deploy ng mga modelo na naglalaman ng makikitaang watermark ay nagpapakita sa mga decentralized protocol ng operational at legal na panganib, kabilang ang pagkakalayo mula sa mga pangunahing liquidity hubs at institutional decentralized finance integrations. Ang mga proyekto ay nag-aadopt ng mga mahigpit na data auditing frameworks upang matiyak na ang kanilang mga training resources ay hindi lumabag sa mga proprietary assets.
Verifiable Inference at Zero-Knowledge Proofs
Habang lumalawak ang mga panganib ng distilasyon at pagpapalit ng modelo, ang mga cryptocurrency protocol ay nagpapalakas ng mga mekanismo ng verifiable inference na batay sa zero-knowledge machine learning (zkML). Ang mga zero-knowledge proof ay nagpapahintulot sa isang decentralized node na matematikal na patunayan na ang isang inference output ay kalkulahon ng isang tiyak, autentikong modelo nang hindi ipinapakita ang mga nakalalagay na parameter o pribadong prompt inputs.
Ang cryptographic validation na ito ay nagpapatunay na ang mga node ay tumatakbo sa tunay na mga modelo kaysa sa mga lightweight na distilled na imitasyon na disenyo upang makakuha ng mga reward nang di-maayos. Sa pamamagitan ng paghingi ng cryptographic execution proofs, ang decentralized networks ay nagtitiyak na ang mga user ay natatanggap ang autentikong intelligence. Habang ang zkML ay nagpapatotoo sa execution fidelity sa-chain, ang frontier provider defenses ay nagpapanatili sa unang pag-unlad ng modelo, bumubuo ng isang integrated security boundary para sa emerging autonomous digital economy.
Kongklusyon
Ang mga pag-atake sa distilasyon ng AI ay kumakatawan sa isang kalkuladong vektor ng pagkuha na tumutukoy sa mga propiyetaryong intelehensiya, mga decentralizadong network ng kompyutasyon, at mga awtonomong sistema ng Web3. Sa pamamagitan ng pagpapatakbo ng automated, malawakang kampanya ng pagtanong, ang mga kalaban ay sumisikap na i-bypass ang mga pangunahing gastos sa pagtuturo at muling ipakita ang mga kakayahan sa pag-iisip sa pinakamataas na antas nang mababa ang gastos. Tinutugunan ng Anthropic ang hamon na ito sa pamamagitan ng isang integradong arkitektura ng depensa na naglalaman ng dinamikong pagklasipikasyon ng intensyon, multi-tenant behavioral clustering, pagpapatupad ng context provenance, at cryptographic output watermarking. Sa loob ng decentralized finance at DePIN systems, kung saan ang awtonomong pagdedesisyon ay nangangailangan ng maaasahang, hindi pinapababang halaga na intelehensiya, ang mga sistemang ito ay nagpapanatili ng sustainability ng protocol at nag-iwas sa pagbaba ng halaga ng mga token ng kompyutasyon. Habang lumalago ang sektor ng machine learning sa buong 2026, ang pangunahing tulong ay magiging ang pagprotekta sa model weights, pagpapakatotoo ng verifiable inference, at pagpapatibay sa provenance ng data na nagpapagana sa mga awtonomong network ng software.
🔥 Sa Labas ng Mga Balita: Ano ang Kahulugan ng KuCoin 5.0 para sa Iyo
Mabilis ang paggalaw ng balita sa merkado — ngunit mahalaga rin kung saan mo ito ginagamit. Sa buwan ng Oktubre, ilalunsad ng KuCoin ang KuCoin 5.0, na nagpapalit sa KuCoin sa isang bagong binuo na platform. Narito ang mga tunay na pagbabago para sa iyo:
-
Isang account para sa lahat. Ang mga lumang platform ay naghihiwalay ang pera mo sa mga hiwalay na “spot,” “margin,” at “futures” account at inaasahan na maintindihan mo kung bakit. Ang unified account ng KuCoin 5.0 ay tinatanggal iyon — mag-deposit ng isang beses, at lahat ay direktang narito (kasalukuyang available lamang sa mga VIP).
-
Mga stocks, indices, at commodities. Ang KuCoin 5.0 ay lumalawak sa labas ng crypto patungo sa mga global na merkado. Kapag nagpapahinga ang crypto at tumataas ang equities (o kaya naman ang kabaligtaran), maaari kang mag-rotate sa minuto, hindi kailangang buksan ang isang brokerage account at maghintay ng ilang araw para sa fiat rails.
-
Mga aktibong sa totoong mundo (RWA). Tokenized na eksposur sa tradisyonal na mga aktibo tulad ng mga komodidad, direkta sa iyong crypto account. Isa sa mga pinakamabilis na umuunlad na sektor sa pandaigdigang finansya ay hindi na eksklusibo para sa mga institusyon — ikaw ay makakapag-access dito mula sa parehong balanse na ginagamit mo para mag-trade.
-
Kita habang natututo. Hindi handa na mag-trade? KCUSD ay nagpapakita ng araw-araw na kita na auto-compound sa iyong stablecoin. Ang pinakamaliit na stress na paraan upang gawing produktibo ang iyong hindi ginagamit na deposito na may 4% yield.
-
Isang AI assistant na nasa simpleng wika. Magtanong, makakuha ng konteksto ng merkado, maintindihan ang iyong pinag-uusapan — nakabuilt sa platform, walang kailangang jargon.
-
Isang app na hindi nagpapabigat. Mas mabilis, mas malinis, at mas magkakasundo — intuwitibo agad mula sa unang pag-tap, hindi pagkatapos ng tutorial.
-
Ligtas na maaari mong i-check, hindi lang i-trust. Isang EU na entidad na may lisensya sa MiCAR, Proof of Reserves na maaari mong i-verify mismo, at internasyonal na sertipikadong seguridad (SOC 2 Type II, ISO 27001:2022).
Lumikha ng iyong account sa ilang minuto — at magsimula sa platform na gawa para sa kinabukasan ng crypto, hindi sa nakaraan nito.
Kahit anong tanong
Ano ang teknikal na pagkakaiba sa pagpapalawig ng modelo at pagpapaliit ng modelo?
Ang fine-tuning ay nag-aadjust ng mga panloob na parameter ng isang umiiral na foundational model gamit ang mga target na dataset upang mapabuti ang kanyang performance para sa mga partikular na gawain. Ang distillation ay nagpapadala ng mga kakayahan at mga paraan ng pag-iisip ng isang malaking teacher model sa isang buong iba’t ibang student model sa pamamagitan ng pagtuturo sa student sa mga output na ginawa ng teacher.
Maaari bang tanggalin ng mga kalaban ang mga estadistikal na watermark sa mga output ng modelo?
Maaaring dilawin ang mga watermark sa pamamagitan ng pangalawang pagsasalaysay, semantic scrambling, o pagpagsasama ng mga output mula sa maraming magkakaibang arkitektura. Gayunpaman, ang ganap na pag-alis ng mga multi-bit statistical watermark ay karaniwang nagdudulot ng pagbaba sa presisyon ng pag-iisip at sintaktikong istruktura, at nananatiling nakikita ang mga pangunahing matematikal na lagay sa malalaking dataset ng pagtuturo.
Lahat ba ng mga anyo ng synthetic data generation ay klasipikado bilang distillation attacks?
Hindi naglalayon ang paggawa ng sintetikong data bilang isang pag-atake sa pagpapadali kung hindi ito lumalabag sa mga nakakabinding tuntunin ng serbisyo ng isang API provider, naglilipat-lipat sa mga kontrol ng pag-access, o naglalayong ma-extract nang walang pahintulot ang mga propiyetaryong pagsusuri na tala upang kopyahin ang mga komersyal na kakayahan sa mga kalaban na modelo.
Paano nauugnay ang zero-knowledge proof sa model distillation sa public blockchain?
Ang zero-knowledge machine learning ay nagpapatotoo na ang isang output ay ginawa ng isang partikular na arkitektura ng modelong walang pagpapakita ng mga timbang ng model o pribadong input. Habang ito ay nagpapatotoo sa integridad ng pagpapatakbo at nagpapigil sa mga operator ng node na magpalit nang lihim ng distilled clones, hindi ito nagpapigil sa isang awtorisadong user na gamitin ang mga napatotohanang output upang ituro ang isang off-chain model.
Nagdudulot ba ng pagbaba sa performance ng mga imitation model ang sobrang distilasyon?
Oo. Ang mga distilled systems na tinuturuan lamang sa synthetic outputs ay madalas na nagdudulot ng model collapse at kumulatibong hallucinations. Walang pagkakabase sa malawak na pangunahing corpus ng pagtuturo at tao na pagpapatotoo, ang distilled clones ay nahihirapan sa mga bagong problema at nabibigo kapag inilalabas sa mga kumplikadong gawain labas sa kanilang maliit na training examples.
Disclaimer: Ang artikulong ito ay para sa mga layuning impormatibo lamang at hindi nagtataglay ng financial o investment advice. Ang mga pag-invest sa cryptocurrency ay may malaking panganib. Laging gawin ang iyong sariling pag-aaral bago mag-trade.
Disclaimer: AI technology ang ginamit sa pag-translate ng page na ito para sa convenience mo. Para sa pinaka-accurate na impormasyon, mag-refer sa original na English version.