

Qu'est-ce que les attaques par distillation de modèles IA ? Comment Anthropic protège Claude
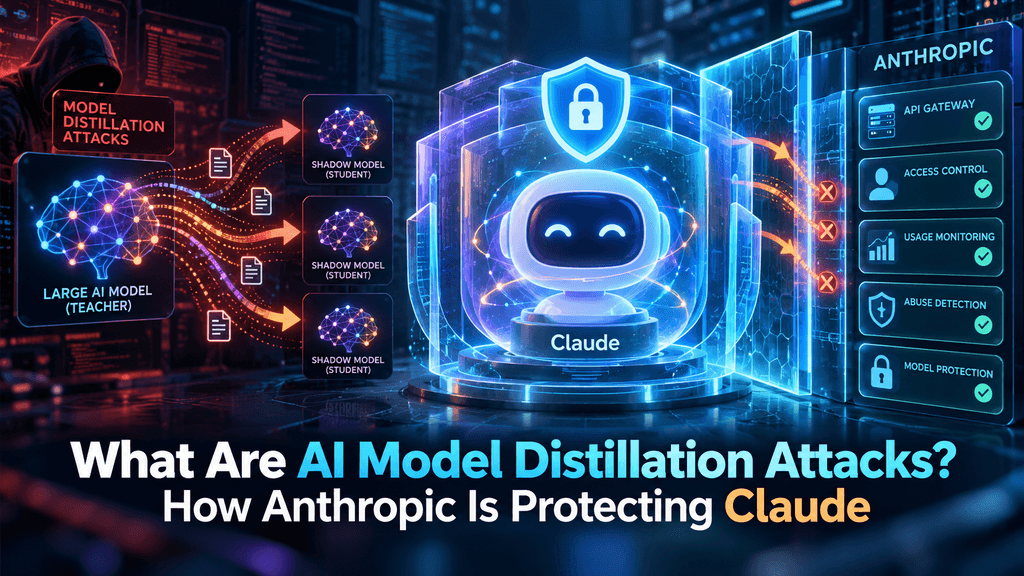
Des millions de dollars de recherche en intelligence artificielle propriétaire pourraient-ils être détournés simplement en interrogeant une API publique ? Les attaques par distillation de modèles permettent à des entités malveillantes d’interroger systématiquement des systèmes de pointe comme Claude afin de récolter des chemins de raisonnement à forte densité, des schémas de fonctions et une logique interne pour former des systèmes concurrents à une fraction du budget de développement standard. Dans les réseaux décentralisés d’infrastructure physique (DePIN) et les écosystèmes de cryptomonnaies, cette menace met directement en péril les pools de calcul décentralisés, les marchés d’intelligence à poids ouvert et l’infrastructure d’agents autonomes. En clonant les capacités de pointe, les adversaires sapent les réseaux tokenisés et les outils de sécurité des contrats intelligents sans financer la recherche fondamentale. Anthropic a contré cette menace en déployant des systèmes de classification multi-niveaux, un regroupement comportemental automatisé, un marquage des sorties et des ajustements dynamiques de l’inférence. Cette analyse examine les mécanismes des attaques par distillation, leurs conséquences graves pour les marchés d’IA décentralisés et l’architecture de défense multicouche d’Anthropic.
Points clés
-
Concept de base : Les attaques par distillation de modèle exploitent les interfaces de programmation d'inférence publiques pour générer des corpus synthétiques denses, permettant aux attaquants de cloner le comportement de raisonnement propriétaire tout en contournant les coûts de recherche sous-jacents.
-
Vulnérabilités Web3 : les écosystèmes d'IA décentralisés, les bots autonomes sur chaîne et les réseaux de calcul tokenisés font face à des risques structurels graves lorsque la distillation non autorisée marchandise les capacités uniques des modèles.
-
Mesures de contournement d'Anthropic : les mécanismes de défense incluent l'analyse en temps réel de l'intention, la télémétrie comportementale multi-locataire, la protection du raisonnement contextuel et le marquage cryptographique des jetons.
-
Exploitation pilotée par Sybil : les campagnes d'extraction utilisent des anneaux de proxys décentralisés, des canaux de paiement virtuels en rotation et des réseaux de cryptomonnaies pseudonymes pour dissimuler une collecte à grande échelle sous forme de trafic utilisateur organique.
-
Évolution de l'économie du marché : des défenses solides éliminent les raccourcis d'imitation bon marché, obligeant les développeurs des secteurs de la technologie traditionnelle et du Web3 à investir directement dans des jeux de données fondamentaux authentiques et des inférences vérifiables.
Quelles sont les attaques par distillation de modèles IA ?
Les mécanismes : comment l'extraction exploite les interfaces des modèles
Les attaques par distillation de modèles exploitent l'accès régulier à l'API pour récolter des propriétés intellectuelles propriétaires et dupliquer des capacités de pointe. La création de modèles de pointe exige des centaines de millions de dollars en clusters de matériel dédié, des pipelines synthétiques affinés et un apprentissage par renforcement intensif. En revanche, un attaquant déclenche des lots de requêtes automatisées dans des domaines spécialisés, collecte les sorties complètes du modèle cible et utilise ce matériel structuré pour affiner des architectures plus petites et à poids ouverts. Ce processus contourne les barrières en capital et en ingénierie qui définissent le développement moderne de l'apprentissage automatique.
L'attaque cible les interfaces standard de génération de texte. Étant donné que les systèmes avancés sont conçus pour fournir des analyses claires et détaillées des problèmes lorsqu'ils répondent à des requêtes de programmation ou mathématiques, ils émettent involontairement les signaux d'instruction exacts nécessaires à l'entraînement de modèles d'imitation. L'attaquant soumet des défis logiques complexes, enregistre les étapes intermédiaires de raisonnement et compile un corpus d'entraînement dense. Lorsqu'il est ingéré par un modèle récepteur plus petit, ces données soigneusement sélectionnées permettent au système d'imitation d'atteindre les performances des benchmarks tout en dépensant moins d'un pour cent du capital d'entraînement original. Étant donné que les requêtes ressemblent à des demandes légitimes de développeurs, les défenses périmétriques traditionnelles ne reconnaissent pas l'extraction.
Exploitation des données synthétiques et extraction du raisonnement
L'extraction des traces de raisonnement intermédiaires accélère considérablement l'apprentissage par imitation par rapport à un pré-entraînement non supervisé standard. Les attaquants se concentrent sur des domaines à fort effet de levier tels que la vérification automatisée de contrats intelligents, la négociation théorique des jeux, l'arbitrage sur les échanges décentralisés et les mathématiques symboliques. En soumettant des invites conçues pour forcer une logique étape par étape, l'adversaire convertit la plateforme cible en un générateur automatique de jeux de données.
-
Récolte par chaîne de raisonnement : Extraction des étapes intermédiaires de résolution de problèmes pour distiller des processus cognitifs vers des réseaux de destinataires non alignés ou non autorisés.
-
Utilisation d'outils et vol de schémas : Capture des structures d'appel de fonctions, des sorties JSON structurées et des procédures de récupération pour former des agents d'exécution autonomes.
-
Analyse des limites de sécurité : évaluation systématique des garde-fous pour cartographier les filtres de modération et former des modèles secondaires contournant les protocoles d'alignement standards.
Topologies d'attaque : campagnes d'extraction distribuées
Les campagnes modernes de distillation utilisent une infrastructure distribuée plutôt que des clients isolés pour éviter les limites de débit basées sur le volume. Ces opérations s'appuient sur des pools de proxies, des profils d'identité rotatifs et un hébergement multi-locataire pour imiter des schémas d'interaction détaillés variés.
| Vecteur d'attaque | Mécanisme de déploiement | Actif cible | Complexité de détection |
| Pools de requêtes coordonnées | Botnets distribués faisant tourner les clés d'accès client | Preuves mathématiques approfondies, logique des contrats intelligents | Élevé |
| Prompts de détail simulés | Variantes paraphrasées des référentiels académiques standards | Connaissances spécialisées du domaine institutionnel | Très élevé |
| Boucles d'agent autonome | Pipelines d'auto-prompting exécutant des travaux en plusieurs étapes | Schémas d'exécution, corrections d'erreurs en temps réel | Extrême |
| Scans frontières adverses | Tests automatisés des limites de garde-fous | Limites de sécurité opérationnelle, seuils de modération | Modéré |
Ces réseaux distribués utilisent fréquemment les infrastructures de cryptomonnaies pour maintenir l'anonymat. Les attaquants financent les clés d'accès à l'aide de fournisseurs de paiement virtuels alimentés par des actifs décentralisés, rompant ainsi les liens de vérification d'identité utilisés par les plateformes cloud d'entreprise. En conséquence, les campagnes d'extraction se fondent dans la croissance normale du trafic plutôt que d'apparaître comme des opérations coordonnées.
Intersection avec Web3 et cryptomonnaie
Vecteurs de menace contre DePIN et le calcul décentralisé
La distillation de modèles pose un défi économique immédiat aux réseaux d'intelligence artificielle Web3 et aux systèmes d'infrastructure physique décentralisée. Les réseaux DePIN coordonnent des clusters de matériel distribué pour former, évaluer et héberger des modèles grâce à des incitations sous forme de jetons. Lorsque des modèles hébergés sur des nœuds ouverts sont systématiquement extraits par distillation non autorisée, la valeur intrinsèque soutenant les jetons d'utilité natives se détériore.
Si l'accès aux nœuds du modèle décentralisé permet de créer des clones locaux auto-hébergés, la demande pour le staking natif et les jetons utilitaires diminue. La distillation marchandise les sorties computationnelles avant que les réseaux ne puissent établir un revenu régulier provenant des frais. Par exemple, si un écosystème dépense des fonds de trésorerie pour développer un moteur d'analyse blockchain spécialisé, un adversaire peut extraire ces capacités de raisonnement en quelques jours, déployer un modèle identique sur un réseau alternatif, proposer des prix inférieurs et diluer la position sur le marché du projet original.
Vulnérabilités des agents de contrats intelligents et sécurité sur chaîne
Des agents autonomes qui utilisent des modèles de pointe pour l'optimisation des rendements, la gestion de la liquidité et l'évaluation des contrats intelligents font face à une duplication opérationnelle sévère. Les adversaires surveillent les activités des agents pour isoler les stratégies d'exécution, les paramètres de risque et les mécanismes de validation.
-
Réplication de stratégie : Les concurrents clonent les algorithmes de market-making autonomes en capturant les cadres de décision générés par les agents de pointe.
-
Accélération de l'exploitation : Des modèles clonés, formés sur des heuristiques de sécurité extraites, permettent aux adversaires d'effectuer des analyses de vulnérabilités hors ligne, révélant des défauts de contrat sans diffuser d'activité sur les registres publics.
-
Boucles de financement Sybil : Des entités non réglementées utilisent des wallets axés sur la confidentialité et des outils financiers décentralisés pour financer des clusters de scraping, en contournant les vérifications de connaissance du client.
Interruption du staking dans l'apprentissage automatique décentralisé
La sécurité économique des réseaux d'IA mis en staking repose sur l'hypothèse que la génération d'une intelligence de haute qualité exige une dépense importante de ressources. Dans un cadre d'apprentissage automatique à preuve de staking, les opérateurs de nœuds déposent une garantie pour garantir des sorties précises et computativement intensives.
La distillation compromet cet équilibre d'incitation. Un opérateur malveillant peut distiller un modèle propriétaire dans une architecture légère d'imitation, exécuter cette copie sur du matériel grand public peu coûteux, et soumettre ses sorties au réseau. Étant donné que l'imitation correspond aux critères de validation standards, l'opérateur reçoit la totalité des récompenses de validation tout en supportant une fraction seulement des coûts informatiques légitimes. Cette dynamique pénalise les opérateurs honnêtes qui maintiennent une infrastructure d'entreprise dédiée, encourageant la centralisation du réseau et minant la confiance dans le protocole décentralisé.
Comment Anthropic protège Claude
Classification dynamique des intentions en deux étapes
Anthropic applique un cadre de classification en deux étapes pour intercepter les requêtes d'extraction avant qu'elles ne génèrent des données d'entraînement. Plutôt que de s'appuyer sur des listes noires de mots-clés simples, les requêtes sont analysées selon des dimensions sémantiques, syntaxiques et structurelles.
La première étape effectue un profilage sémantique structurel. Le classificateur évalue si une invite entrante présente des signes de génération de jeu de données programmatique — telles que des permutations répétitives ou des structures de référentiels académiques — plutôt qu'une utilisation organique par les développeurs. La deuxième étape surveille en temps réel la dynamique d'émission des jetons de sortie afin d'intercepter les requêtes conçues pour extraire des délibérations cachées. Lorsqu'une extraction à haute probabilité est détectée, la plateforme déclenche des ajustements dynamiques de la réponse, en fournissant une réponse directe tout en retenant les traces de raisonnement intermédiaires nécessaires aux attaquants pour le raffinage.
Télémétrie comportementale multi-locataire et regroupement
Pour exposer les anneaux de clients distribués, Anthropic corrèle les témoignages comportementaux à travers des comptes utilisateurs apparemment indépendants. Étant donné que la distillation nécessite d'immenses volumes de données, les campagnes de collecte génèrent des corrélations statistiques détectables sur le réseau.
Lorsque des comptes disparates à travers des espaces IP et des modes de paiement diversifiés présentent des rythmes comportementaux parallèles, la plateforme signale la corrélation. Le moteur de télemétrie évalue les modèles de syntaxe de demande correspondants, les demandes de jetons synchronisées et les explorations de domaines complémentaires. Si des milliers de comptes indépendants interrogent des permutations de défis de programmation identiques dans des séquences décalées, le système les attribue à une opération coordonnée. Anthropic applique alors des ajustements de taux coordonnés, une journalisation détaillée et la révocation simultanée de l'accès pour démanteler le réseau.
Protection de la fenêtre de contexte
Une méthode de distillation éprouvée implique la manipulation du contexte, où les attaquants collent les étapes antérieures de raisonnement du modèle dans de nouvelles invites afin d'inciter à une divulgation technique continue.
Anthropic a éliminé cette vulnérabilité en révisant les mécanismes de traitement du contexte. Le système met en œuvre un suivi strict de la provenance de tous les jetons dans la fenêtre de contexte, en distinguant entre les entrées utilisateur externes, l'historique de génération antérieur et les éléments de raisonnement protégés. Lorsqu'un utilisateur injecte des traces de raisonnement précédemment générées pour forcer une divulgation systématique, le modèle reconnaît le modèle adversarial et interrompt le chemin d'exécution, bloquant l'utilisation des fenêtres de contexte longues comme vecteurs d'extraction.
Marquage d'eau des sorties cryptographiques et statistiques
Anthropic utilise le marquage statistique pour intégrer des motifs structurels vérifiables dans les séquences de sortie, fournissant une preuve mathématique d'origine sans compromettre la clarté, la fluidité ou la précision technique.
La technique fondamentale utilise des ajustements de fréquence de jetons pseudorandom. Le moteur de génération privilégie subtilement des jetons synonymes spécifiques en fonction d'une clé cryptographique interne. Bien que la sortie semble naturelle pour les lecteurs humains, une analyse statistique de grands jeux de données générés par un modèle clone présumé révèle s'il a été formé sur des sorties de Claude. Cette attribution de provenance fournit des preuves exploitables pour poursuivre des revendications de propriété intellectuelle, supprimer les modèles non autorisés des dépôts ouverts et invalider les services illégitimes sur les réseaux décentralisés.
Mesures économiques
La défense la plus résistante contre la distillation de modèle perturbe les calculs financiers de l'attaquant. La distillation n'est viable que lorsque l'interrogation d'une API est considérablement moins coûteuse que le développement indépendant d'un modèle. Anthropic aligne les défenses techniques avec des pénalités économiques.
| Couche de protection | Focus opérationnel | Résultat stratégique |
| Classificateur en deux étapes | Analyse sémantique en temps réel | Neutralise les invites d'extraction avant la génération |
| Regroupement comportemental | Corrélation de schéma entre comptes | Démantèle les botnets de rassemblement distribués |
| Protection du contexte | Traçage de la provenance des jetons | Empêche l'extraction par injection de prompt |
| Marques d'eau statistiques | Ajustements de fréquence des jetons cryptographiques | Fournit une attribution vérifiable des données volées |
Lorsque les classificateurs d'intention détectent une tentative d'extraction et passent à des sorties concises, la plateforme traite la demande aux tarifs standard. De plus, lorsque l'empreinte comportementale confirme l'existence d'un réseau d'extraction distribué, les comptes associés sont suspendus et les soldes préfinancés sont forfeités pour violation des conditions d'utilisation. La facturation pour des données d'entraînement non viables, combinée à la neutralisation des comptes opérationnels, rend l'extraction à grande échelle économiquement inviable.
Implications stratégiques pour les marchés de la crypto et de l'IA
Évolution de l'économie de l'apprentissage automatique
La mise en œuvre de défenses de distillation efficaces modifie l'économie unitaire du développement de l'IA à la fois dans le calcul traditionnel et les protocoles décentralisés. Alors que les plateformes de pointe restreignent les fuites d'entraînement synthétiques, la construction de modèles performants exige à nouveau une capacité computationnelle réelle, une innovation architecturale et des jeux de données vérifiés.
Cette transition accélère la consolidation des capitaux à travers les protocoles d'intelligence décentralisée. Les équipes ne peuvent plus maintenir leurs propositions de valeur en emballant des sorties distillées dans des conteneurs ouverts. Les initiatives décentralisées doivent investir dans la recherche fondamentale, des retours humains vérifiés cryptographiquement et une infrastructure dédiée. Les marchés d'actifs numériques reflètent ce changement, réallouant les capitaux loin des conteneurs dérivés vers des protocoles fondamentaux qui démontrent une authenticité de formation prouvable et des architectures de modèle durables.
Renforcement des écosystèmes à poids ouvert
La frontière entre la recherche open-source et l'intelligence propriétaire est définie par la manière dont la provenance des données est gérée. Les modèles à poids ouverts, formés sur des jeux de données publics vérifiés, restent essentiels pour des systèmes transparents et décentralisés. Toutefois, les systèmes dépendant de la distillation non autorisée font face à des perturbations soudaines dues à des mesures de prévention au niveau des plateformes et à des responsabilités réglementaires.
Les organisations Web3 combinant l'apprentissage automatique et les infrastructures blockchain doivent construire des pipelines de données vérifiables. Le déploiement de modèles contenant des filigranes détectables expose les protocoles décentralisés à des risques opérationnels et juridiques, notamment l'exclusion des principaux centres de liquidité et des intégrations avec la finance décentralisée institutionnelle. Les projets adoptent des cadres stricts d'audit des données pour confirmer que leurs ressources d'entraînement ne violent pas les actifs propriétaires.
Inférence vérifiable et preuves à divulgation nulle de connaissance
Alors que les risques de distillation et de substitution de modèles s'étendent, les protocoles de cryptomonnaie intègrent des mécanismes d'inférence vérifiables basés sur l'apprentissage automatique à preuve à divulgation nulle de connaissance (zkML). Les preuves à divulgation nulle de connaissance permettent à un nœud décentralisé de prouver mathématiquement qu'une sortie d'inférence a été calculée par un modèle spécifique et authentique, sans révéler les paramètres sous-jacents ni les entrées de prompt privées.
Cette validation cryptographique garantit que les nœuds exécutent des modèles authentiques plutôt que des imitations légères et distillées conçues pour capter récompenses de manière frauduleuse. En exigeant des preuves de exécution cryptographiques, les réseaux décentralisés assurent que les utilisateurs reçoivent une intelligence authentique. Alors que zkML vérifie la fidélité d'exécution sur chaîne, les défenses des fournisseurs de pointe protègent le développement initial du modèle, formant ainsi une frontière de sécurité intégrée pour l'économie numérique autonome émergente.
Conclusion
Les attaques par distillation de modèles d'IA représentent une vecteur d'extraction calculé ciblant l'intelligence propriétaire, les réseaux de calcul décentralisés et les systèmes autonomes Web3. En exécutant des campagnes de requêtes automatisées à grande échelle, les adversaires tentent de contourner les coûts fondamentaux d'entraînement et de reproduire les capacités de raisonnement de pointe à faible coût. Anthropic répond à ce défi grâce à une architecture de défense intégrée combinant la classification dynamique des intentions, le regroupement comportemental multi-locataire, l'application de la provenance contextuelle et le marquage cryptographique des sorties. Dans les systèmes de finance décentralisée et DePIN, où la prise de décision autonome exige une intelligence fiable et non compromise, ces systèmes de défense préservent la durabilité des protocoles et empêchent la dévaluation des jetons d'incitation computationnelle. Au fur et à mesure que le secteur de l'apprentissage automatique évolue tout au long de 2026, l'accent opérationnel sera mis sur la protection des poids des modèles, la garantie d'inférences vérifiables et la certification de la provenance des données alimentant les réseaux de logiciels autonomes.
🔥 Au-delà des titres : ce que KuCoin 5.0 signifie pour vous
Les actualités du marché évoluent rapidement — mais où vous agissez dessus compte tout autant. Ce octobre, KuCoin lance KuCoin 5.0, transformant KuCoin en une plateforme entièrement重构. Voici ce qui change réellement pour vous :
-
Un seul compte pour tout. Les anciennes plateformes répartissaient votre argent entre des comptes séparés « spot », « marge » et « futures » et s’attendaient à ce que vous compreniez pourquoi. Le compte unifié de KuCoin 5.0 élimine entièrement cela — déposez une fois, et tout est simplement disponible (actuellement uniquement disponible pour les VIP).
-
Actions, indices et matières premières. KuCoin 5.0 s'étend au-delà du crypto vers les marchés mondiaux. Lorsque le crypto stagne et que les actions progressent (ou l'inverse), vous effectuez une rotation en quelques minutes au lieu d'ouvrir un compte courtier et d'attendre des jours pour les voies monétaires.
-
Actifs du monde réel (RWA). Une exposition tokenisée à des actifs traditionnels comme les matières premières, directement dans votre compte crypto. L’un des segments à la croissance la plus rapide de la finance mondiale n’est plus réservé aux institutions — vous y accédez depuis le même solde que celui que vous utilisez pour trader.
-
Gagnez tout en apprenant. Pas prêt à trader ? KCUSD permet à vos stablecoins de générer des intérêts quotidiens, avec un auto-compound. La manière la moins stressante de faire travailler vos dépôts inactifs pour un rendement de 4 %.
-
Un assistant IA en langage simple. Posez des questions, obtenez du contexte sur le marché, comprenez ce que vous voyez — intégré à la plateforme, aucun jargon nécessaire.
-
Une application qui ne submerge pas. Plus rapide, plus propre et cohérente — intuitive dès le premier toucher, sans besoin de tutoriel.
-
Sécurité que vous pouvez vérifier, et non simplement confier. Une entité européenne autorisée MiCAR, Proof of Reserves que vous pouvez vérifier vous-même, et une sécurité certifiée au niveau international (SOC 2 Type II, ISO 27001:2022).
Créez votre compte en quelques minutes — et commencez sur la plateforme conçue pour où va la crypto, pas où elle en est venue.
FAQ
Quelle est la différence technique entre le raffinage de modèle et la distillation de modèle ?
Le fine-tuning ajuste les paramètres internes d'un modèle fondamental existant à l'aide de jeux de données ciblés pour optimiser ses performances sur des tâches spécifiques. La distillation transfère les capacités et les méthodes de raisonnement d'un modèle enseignant massif vers un modèle élève entièrement distinct en formant l'élève sur les sorties produites par l'enseignant.
Les filigranes statistiques dans les sorties de modèle peuvent-ils être supprimés par des adversaires ?
Les filigranes peuvent être dilués par une reformulation secondaire, un brouillage sémantique ou la combinaison de sorties provenant de plusieurs architectures distinctes. Toutefois, supprimer complètement les filigranes statistiques multi-bit dégrade généralement la précision du raisonnement et la structure syntaxique, et les signatures mathématiques sous-jacentes restent détectables sur de grands jeux de données d'entraînement.
Toutes les formes de génération de données synthétiques sont-elles classées comme des attaques par distillation ?
Non. La génération de données synthétiques constitue une attaque par distillation uniquement lorsqu'elle viole les conditions d'utilisation contraignantes du fournisseur d'API, contourne les contrôles d'accès ou extrait intentionnellement des traces de raisonnement propriétaires sans autorisation pour reproduire des capacités commerciales dans des modèles concurrents.
Comment les preuves à divulgation nulle de connaissance sont-elles liées à la distillation de modèles sur les blockchains publiques ?
L'apprentissage automatique à preuve nulle vérifie qu'une sortie a été générée par une architecture de modèle spécifique sans révéler les poids du modèle ni les entrées privées. Tout en confirmant l'intégrité de l'exécution et en empêchant les opérateurs de nœuds de substituer secrètement des clones distillés, il ne empêche pas un utilisateur autorisé d'utiliser des sorties vérifiées pour former un modèle hors chaîne.
La distillation excessive dégrade-t-elle les performances des modèles d'imitation ?
Oui. Les systèmes distillés formés exclusivement sur des sorties synthétiques souffrent fréquemment d'effondrement du modèle et d'hallucinations cumulatives. Sans ancrage dans de larges corpus d'entraînement primaires et de validation humaine, les clones distillés peinent face à de nouveaux domaines de problèmes et échouent lorsqu'ils sont confrontés à des tâches complexes en dehors de leurs exemples d'entraînement restreints.
Avertissement : Cet article a uniquement une finalité informative et ne constitue pas un conseil financier ou en matière d'investissement. Les investissements dans les cryptomonnaies comportent des risques significatifs. Effectuez toujours vos propres recherches avant de trader.
Avertissement : Pour votre confort, cette page a été traduite à l'aide de la technologie IA. Pour obtenir les informations à la source, consultez la version anglaise originale.