

Bumaba ang stock ng Cerebras ng 20% pagkatapos pumili ang OpenAI ng mga chip ni Nvidia: Ano ang ibig sabihin nito para sa labanan ng AI chip
Naging sentro ng pansin ang Cerebras Systems pagkatapos bumaba ng halos 20% ang stock ng CBRS mula sa huling bahagi ng Setyembre hanggang sa maagang Oktubre 2026. Ang pagbaba ay sumunod sa mga ulat na ginagamit ni OpenAI ang Nvidia GPUs para sa isang GPT-6.1 Sol Ultrafast workload, na nagdulot ng mga bagong tanong tungkol sa kompetisyon sa AI chip market. Ang selloff ay epekto rin ng pagkakabukas ng mga share pagkatapos ng IPO at mga pagpapahayag ng pagbebenta ng mga insider. Hindi pa natapos ni OpenAI ang kanilang pakikipagtulungan kay Cerebras, kaya ang pangunahing isyu ay kung kayang saktan ni Nvidia ang Cerebras nang mas direkta sa low-latency AI inference.
Bakit bumaba ang stock ng Cerebras ng halos 20%?
Ang stock ng Cerebras ay nagsailalim sa malakas na presyon sa huli ng Setyembre at sa simula ng Oktubre 2026, bumaba mula sa $206.75 noong Setyembre 25 patungo sa $166.43 noong Oktubre 2. Ito ay nangangahulugan ng pagbaba ng halos 19.5%, na nagdala ng CBRS sa ilalim ng presyong IPO na $185. Ang pinakamalakas na pagbaba ay nangyari noong Setyembre 30, nang bumaba ang stock ng 8.87%. Habang ang mga ulat na nag-uugnay sa pinakabagong ultra-fast AI workload ni OpenAI sa Nvidia ang naging pangunahing katalis na may kinalaman sa teknolohiya, ang pagbebenta ay hindi dininig ng isang kaganapan lamang. Ang isang nakatakdang pagbukas ng mga bahagi pagkatapos ng IPO at mga pagpapahayag ng pagbebenta ng mga insider ay dumating sa parehong panahon, na nagdagdag ng isa pang pinagmumulan ng presyur sa pagbebenta at kawalan ng katiyakan tungkol sa stock. Ang kombinasyon ay naggawing mas mahirap para sa mga investor na hiwalayin ang mga alalahanin tungkol sa kompetitibong posisyon ng Cerebras mula sa karaniwang mga dinamikang pamilihan pagkatapos ng IPO. Mahalaga ang pagkakaiba na ito dahil ang halos 20% na pagbaba ay nagpapakita ng ilang magkakalabasan na presyur kaysa isang tiyak na pagbabago sa estratehiya ni OpenAI.
Ipinagtanong ng ulat ng OpenAI-Nvidia ang papel ng Cerebras sa inference
Lumabas ang pinakamalaking bagong pag-aalala pagkatapos ipahayag ng SemiAnalysis na ang OpenAI’s GPT-6.1 Sol Ultrafast workload ay sinusugpo sa Nvidia GPUs kaysa sa Cerebras hardware. Mahalaga ito dahil ang Cerebras ay nagsasagawa na ng nakikita na papel sa mataas na bilis na inference strategy ni OpenAI. Noong Agosto, kinumpirma ni OpenAI na ang GPT-5.6 Sol Ultrafast ay pinapagana ng Cerebras at kayang magbigay ng output speed na hanggang 750 tokens bawat segundo. Kaya may dahilan ang mga investor na subaybayan kung susunod pa bang magpapagana ng Cerebras ang mga susunod na henerasyon ng pinakamabilis na inference products ni OpenAI. Kung kayang magbigay ng kompetitibong performance ang Nvidia sa katulad na workload, maaaring mabawasan ang pagkakatiwala na may malinaw na advantage ang Cerebras sa bawat ultra-low-latency inference deployment. Sapat ang posibilidad na ito upang magpalit ng mga tanong kung gaano karaming demand sa inference ng OpenAI ang kaya hawakan ng Cerebras sa huli.
Hindi ibinigay ng ulat na natapos na ni OpenAI ang kanyang ugnayan sa Cerebras. Mahaba nang panahon na ang pagkakasaligan ni OpenAI sa mga GPU ng Nvidia, habang nagtatayo rin ito ng mas malawak na portfolio ng compute na kasama ang Cerebras at iba pang mga supplier. Mas mahalaga pa, hindi pa nag-anunsyo si OpenAI ng pagkansela ng kanyang 750MW na kasunduan sa Cerebras, at sinabi ni Sam Altman na ang Cerebras ay isang malapit na kasama. Ang reaksyon ng merkado ay tila nagpapakita ng mas maliit na pag-aalala: kung kayang makipag-competensya ang Nvidia para sa mga parehong low-latency workload kung saan ipinaglalaban ng Cerebras ang kanyang pagiging mabilis, maaaring harapin ng Cerebras ang mas malakas na kompetisyon para sa mga hinaharap na OpenAI inference deployment kaysa sa inaasahan ng ilang investor. Hindi ito kailangang alisin ang Cerebras mula sa infrastructure ni OpenAI, ngunit maaaring magbago ang paraan kung paano isipin ng mga investor ang hinaharap na bahagi nito sa mga mataas na halaga na inference workload. Para sa isang bagong naging public na AI chip company na patuloy pa ring patotohanan ang saklaw ng kanyang komersyal na pagkakataon, kahit isang pinaniniwalaang pagbabago sa pagkakaloob ng customer ay maaaring magkaroon ng sobrang epekto sa damdamin.
Dinagdagan ng pagbabahagi ang presyur sa CBRS Stock
Ang kuwento ng OpenAI-Nvidia ay dumating din habang ang isang malaking bloke ng mga aksyon ng Cerebras ay naging karapat-dapat para sa pagbenta matapos ang IPO ng kumpanya. Noong huling bahagi ng Setyembre, isang inaasahang 19.4 milyong mga aksyon ay inilabas mula sa mga pagkakabukod, kasama ang karagdagang mga yugto na nakadwal sa Oktubre. Lumabas din ang ilang pagpapahayag ng pagbenta ng mga looban sa parehong panahon. Ang mga pangyayaring ito ay hindi nagpapatotoo na lahat ng mga aksyon na nalibre ay agad na binenta, ngunit itinataas ang potensyal na suplay ng mga aksyon ng CBRS na available sa merkado. Para sa isang stock na bago lang lumabas sa pampublikong merkado, ang posibilidad ng karagdagang mga aksyon na maaaring tradein ay maaaring magdulot ng presyong baba kapag ang emosyonal na reaksyon ng mga investor ay nasa pagbaba na. Kung pinagsama-sama, ang ulat ng Nvidia, ang kawalan ng katiyakan tungkol sa hinaharap na papel ng Cerebras sa pinakamabilis na inference workloads ng OpenAI, at ang paglilibre ng mga aksyon matapos ang IPO ay nagbibigay ng mas kompletong paliwanag kung bakit bumaba ang presyo ng Cerebras nang halos 20% sa ilang sesyon ng pagtinda. Kaya, ang pagbaba ay tila hindi isang reaksyon sa isang solong katalis at mas isang kombinasyon ng mga alalahanin tungkol sa kompetisyon, presyur sa suplay, at pagbabago sa mga inaasahan tungkol sa kuwento ng paglago ng Cerebras.
Ang Paglipat ni OpenAI sa Nvidia at Ang Kahulugan Nito para sa Cerebras
Hindi lang problema para sa Cerebras na maaaring kasali si Nvidia sa isa sa pinakabagong high-speed inference workloads ng OpenAI. Mas mahalagang tanong ay kung kayang kumpetahin ng Nvidia ang low-latency inference segment na ginamit ng Cerebras upang magkaiba sa mga tradisyonal na GPU-based na sistema. Binuo ng Cerebras ang kanyang komersyal na kaso sa paligid ng wafer-scale architecture, malaking on-chip memory bandwidth, at ang kakayahan na mag-generate ng tokens sa napakabilis na bilis nang hindi nakabatay sa malalaking cluster ng hiwalay na mga GPU. Kung kayang mabawasan ng Nvidia ang pagkakaiba sa performance habang ibinibigay sa mga customer ang pamilyar na software ecosystem at mas malaking installed infrastructure base, maaaring kailanganin ng Cerebras na patunayan ang kanyang advantage workload sa workload kaysa mag-asa lamang sa raw inference speed.
Hindi ito nagiging hindi mahalaga ang Cerebras sa estratehiya ng infrastruktura ni OpenAI. Lalong lumalawak ni OpenAI ang paggamit ng multi-supplier approach sa AI compute, gumagamit ng iba’t ibang hardware para sa pag-train, inference, at mga espesyalisadong workload batay sa gastos, availability, at performance. Maaari pa ring makabenefit ang Cerebras mula sa modelo na ito kung nananatiling kompetitibo ang mga sistema nito para sa latency-sensitive inference. Ang estratehikong hamon ay ang pagkakaroon na ng mas maraming opsyon ni OpenAI. Sa halip na isang supplier ang dominante sa bawat yugto ng model deployment, maaaring hatiin ang hinaharap na AI infrastructure sa mga Nvidia GPU, Cerebras wafer-scale systems, at iba pang espesyalisadong accelerator, kung saan bawat platform ay makakakuha ng workload kung saan ang arkitektura nito ay nag-aalok ng pinakamahusay na ekonomiya o performance.
Dapat patunayan ng Cerebras ang isang kahihintay na higit sa karaniwang bilis ng inference
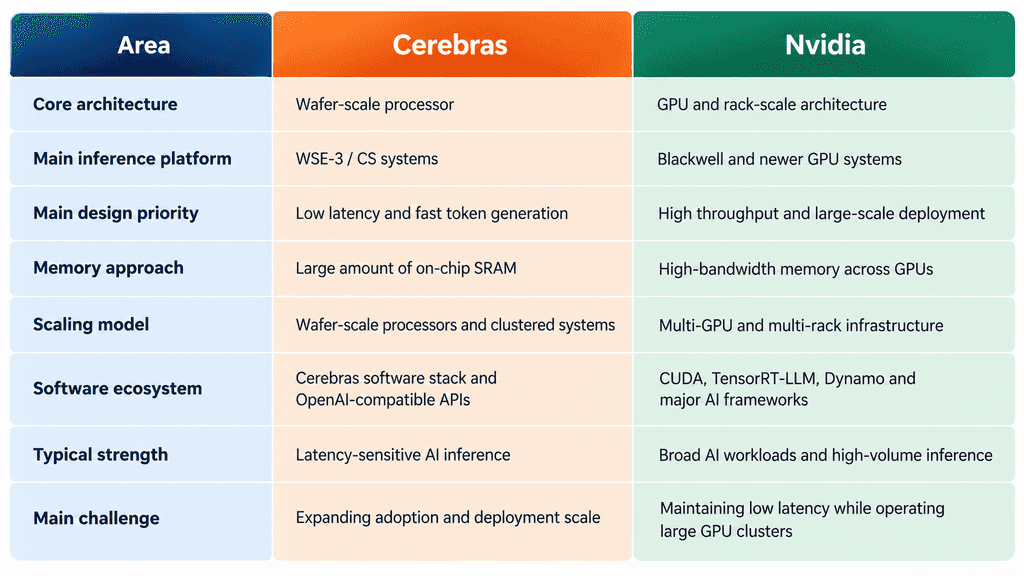
Kinabigyan ng atensyon si Cerebras dahil ang kanyang Wafer-Scale Engine ay gumagamit ng napakalaking pagkakaiba sa GPU architecture na ginagamit ni Nvidia. Sa halip na magkonekta ng malaking bilang ng hiwalay na accelerator chips, isinasaayos ni Cerebras ang napakaraming compute cores sa isang solong wafer-scale processor. Ang disenyo na ito ay maaaring mabawasan ang mga communication bottlenecks at lalo na kapaki-pakinabang para sa mga workload kung saan mahalaga ang latency. Para sa mga customer na nagpapatakbo ng interactive AI assistants, coding models, o real-time inference applications, ang mas mabilis na token generation ay direktang mapapabuti ang user experience.
Gayunpaman, sinusuri ng mga bumibili ng AI infrastructure ang higit pa sa mga token bawat segundo. Ang kabuuang gastos ng pagmamay-ari, epekto sa enerhiya, pagkakatugma ng modelo, mga kasangkapan para sa developer, pagkakataon sa pag-deploy at pagkakaroon ng access sa available capacity ay maaaring mag-impluwensya sa mga desisyon sa pagbili. Ang CUDA software ecosystem ni Nvidia ay patuloy na malalim na nakapaloob sa buong industriya ng AI, habang ang mga sistema nito sa Blackwell-generation ay disenyo upang sirvin ang parehong mataas na throughput at lalong lalo na ang mga workloads na sensitibo sa latency. Kaya kailangan ng Cerebras na ipakita na ang mga advantaheng arkitektural nito ay nagtatapos sa mas mababang gastos o mas malinaw na mas magandang application performance sa komersyal na sukat. Ang pagkukumpara na ito ay lalalong mahalaga habang ang mga kumpanya ng AI ay lumilipat mula sa pag-train ng mas malalaking modelo patungo sa pagpapagana nito nang epektibo sa mga milyon ng gumagamit.
Ang Multi-Chip Strategy ng OpenAI ay maaari pa ring magbigay ng espasyo para sa Cerebras
Ang pagpapalawak ng imprastruktura ng OpenAI ay nagpapakita na ang pagtatalo sa mga chip para sa AI ay hindi malamang magiging isang kompetisyon kung saan ang tagumpay ay sasakop ng lahat. Kailangan ng mga malalaking developer ng AI napakalaking amount ng compute, at ang pagtatatag sa isang supplier ng hardware ay maaaring magdulot ng mga limitasyon sa kapasidad, presyo, at supply chain. Ang paggamit ng ilang arkitektura ng chip ay nagbibigay sa OpenAI ng higit na flexibility upang tugunan ang iba’t ibang modelo at workload gamit ang imprastruktura na pinakamainam para sa bawat gawain. Ang pagkakaroon ng ganitong diskarte ay maaari ring mabawasan ang pagkakasalalay sa anumang isang vendor habang patuloy na tumataas ang demand sa AI inference.
Para sa Cerebras, ang pangunahing pagkakataon ay hindi kailangang palitan ang Nvidia sa buong stack ng infrastruktura ng OpenAI. Mas makatotohanang landas ng paglago ay ang pagkuha ng makabuluhang bahagi ng mga espesyalisadong workload sa inference kung saan ang bilis at mababang latency ay nagpapaliwanag sa paggamit ng iba’t ibang arkitektura. Ang kanilang pangmatagalang position ay magiging batay sa kung kayang nila ituloy ang mga teknikal na advantadyo sa paulit-ulit na deployment sa OpenAI at iba pang mga customer. Mahalaga rin ang kakayahan ng kumpanya na magdiversify sa labas ng isang maliit na bilang ng malalaking client, dahil ang mas malawak na paggamit ay gagawing mas mababa ang sensitibidad ng kanilang negosyo sa mga pagbabago sa paraan kung paano isinasagawa ng anumang isang AI company ang pagkakaloob ng compute sa pagitan ng mga kumpetitor na supplier ng chip.
Cerebras vs Nvidia sa Lumalaking Labanan ng mga Chip para sa AI Inference
Ang paghahambing sa pagitan ng Cerebras at Nvidia ay nagsisiging mas may kahalagahan habang ang mga kumpanya sa AI ay nagbabayad ng higit pa para sa inference, ang yugto kung saan ang mga naituturong modelo ay naglalabas ng mga sagot, code, mga tugon sa boses, at mga aksyon ng agent para sa mga gumagamit. Iba-iba ang pagkakaroon ng Cerebras at Nvidia sa merkado: pinupuntirya ng Cerebras ang wafer-scale processing at napakamababang latency sa pagbuo ng token, habang pinagsasama ng Nvidia ang makapangyarihang mga GPU, mabilis na networking, at matatag na ecosystem ng software upang suportahan ang malalaking AI workload. Ibig sabihin nito, ang labanan sa mga chip para sa AI inference ay hindi lamang tungkol sa kung aling processor ang mas mabilis. Ang gastos bawat token, throughput, latency, efficiency sa enerhiya, suporta sa modelo, at kalakasan sa pag-deploy ay maaaring lahat ay mag-impluwensya kung anong hardware ang pipiliin ng isang kumpanya sa AI para sa isang partikular na workload.
Cerebras vs Nvidia AI Inference: Mga Pangunahing Pagkakaiba
Binubuo ng Cerebras ang kanyang inference platform sa paligid ng Wafer-Scale Engine, na naglalagay ng napakaraming compute cores sa isang solong processor at isinasaayos upang mabawasan ang communication at memory bottlenecks na maaaring magpabagal sa AI inference. Sumusunod ang Nvidia sa mas modular na pagkakabuo, na nag-uugnay ng napakaraming GPUs sa pamamagitan ng teknolohiyang tulad ng NVLink at pagsasama nito sa kanyang CUDA software ecosystem. Nagbibigay ito sa Nvidia ng fleksibilidad sa lahat ng training, inference, at data-center deployments, habang mas malinaw ang pagkakaiba ng Cerebras sa kanyang pagtutok sa mabilis na response times at espesyalisadong inference performance. Kaya ang paghahambing sa dalawa ay nangangailangan ng pagtingin sa arkitektura at deployment strategy, hindi lamang sa isang tokens-per-second benchmark.
Ang ekonomiks ng AI inference ay maaaring mas mahalaga kaysa sa raw speed
Habang tumataas ang paggamit ng AI, ang mga bumibili ng infrastruktura ay lalong nakatuon sa kung gaano karaming magagamit na inference ang maaaring ipagkaloob para sa bawat dolyar at bawat yunit ng enerhiyang kinonsumo. Ang isang platform na nagpapadala ng napakabilis na mga tugon ay maaaring magkaroon ng halaga para sa mga coding assistant, real-time AI agents at interactive applications, ngunit ang mga provider na nagdadala ng milyon-milyon na tokens ay maaaring mas nag-aalala tungkol sa throughput, utilization at gastos bawat token. Lalong pinapahalagahan ni Nvidia ang mga metrikang ito sa kanyang Blackwell-generation systems, na nagpapaliwanag na ang mas bagong mga platform ay maaaring mas mainam na prosesuhin ang mas maraming inference workloads habang pinapabuti ang enerhiyang efficiency at bawasan ang gastos sa pagpapalabas kumpara sa mas lumang hardware ni Nvidia.
Ang Cerebras ay dumadaan sa parehong ekonomiks mula sa iba’t ibang direksyon. Ang arkitektura nito ay disenyo upang panatilihin ang mas maraming model data malapit sa mga compute core, na maaaring mabawasan ang paggalaw ng memorya at mapabuti ang bilis ng pag-generate ng token. Ang kumpanya ay nagsaliksik din sa disaggregated inference, kung saan ang iba’t ibang hardware ay humahawak sa iba’t ibang yugto ng proseso ng inference kaysa magpilit na gamitin ang isang uri ng processor para sa lahat ng gawain. Ang modelo na ito ay maaaring maging mas karaniwan habang hinahanap ng mga AI company ang pinakaepektibong kombinasyon ng hardware para sa prefill, decoding, at long-context reasoning.
Ang mas malawak na merkado ng AI inference ay maaaring maging lalong heterogeneous kaysa sa pagiging pinamumunuan ng isang arkitektura. May abilidad ang Nvidia sa isang malawak na software ecosystem, malaking installed base, at malawak na suporta sa pag-train at inference, habang sinusubukan ng Cerebras na magtatag ng mas malakas na position sa mga workload kung saan ang response time ay lalong mahalaga. Habang ang reasoning models at AI agents ay nagsisiging mas kompyutasyonal na kahilingan, ang kompetitibong advantage ay maaaring maging mas maliit sa isang solong benchmark at mas malaki sa aling platform ang nagdadala ng pinakamabuting balanse ng latency, throughput, consumptions ng enerhiya at gastos bawat token sa komersyal na sukat.
Paano maaaring magbago ang Cerebras Stock dahil sa pagkakasundo sa OpenAI
Para sa Cerebras stock, ang ugnayan sa OpenAI ay mas maaaring magkaroon ng epekto sa pamamagitan ng masukat na mga resultang pampinansyal kaysa bilang isang headline partnership. Maaari ngayon ng mga investor subaybayan kung ang kontratadong kapasidad sa inference ay magiging kita ayon sa takdang oras, kung kayang gawin ng Cerebras ang infrastraktura na kailangan upang matugunan ang kanyang mga pangako, at kung papalawakin ba ng OpenAI ang paggamit nito sa platform. Ang mga pangunahing marka na ito ay maaaring magkaroon ng mas malaking impluwensya sa mas mahabang panahon na kaso ng pag-invest sa CBRS kaysa sa maikling panahong pagbabago sa anong chip ang nagpapagana sa isang indibidwal na modelo o serbisyo.
Maaaring maging mas malaking bahagi ng kuwento ng paglago ng Cerebras ang kita ng OpenAI
Nagsimula ang Cerebras na kilalanin ang kita mula sa kanyang kasunduan sa OpenAI noong unang kuartal ng 2026 at narekord ng $56.8 milyon mula sa kasunduang ito noong ikalawang kuartal, na nagdala ng kabuuang kita sa unang kalahati na may kaugnayan sa kasunduan na $74.4 milyon. Hanggang ika-30 ng Hunyo, ireport ng Cerebras ang $25.4 bilyon sa natitirang obligasyon sa pagganap, kung saan ang isang malaking bahagi ay may kaugnayan sa OpenAI, at sinabi nito na halos 22% ng amount na ito ay inaasahang kilalanin sa loob ng 24 na buwan na nagtatapos noong Hunyo 2028. Para sa mga investor, ang pangunahing isyu ay ang pagkakasunod-kasunod ng kita: ang patuloy na paglago mula sa mga kontratadong obligasyong ito ay magbibigay sa Cerebras ng mas malinaw na pagtingin sa mga hinaharap na benta, habang ang pagkakaroon ng pagkaantala sa pag-deploy o mas mabagal na pagkilala ay maaaring magdulot ng presyon sa mga inaasahan.
Ang pagpapalawak ng kapasidad ay magtataas ng kakayahan ni Cerebras na magbigay sa malaking iskala
Ang laki ng kasunduan sa OpenAI ay nagtataglay din ng hamon sa pagpapatupad. Sinabi ng Cerebras na mayroon itong higit sa 600MW na kapasidad ng data center na nasa aktibong paggamit o ilalabas sa pamamagitan ng dulo ng 2027, habang inaasahan na tataas ang kapasidad sa paggawa ng higit sa sampung beses noong 2026. Nakakuha rin ang kumpanya ng karagdagang supply ng wafers mula sa TSMC habang handa ito para sa mas mataas na pangangailangan. Mahalaga ang mga pamumuhunan na ito dahil kailangan ng Cerebras na isalin ang kanyang teknolohiya sa mapagkakatiwalaang komersyal na imprastruktura sa iba’t ibang data center. Ang pag-unlad sa pagpapalawak ng kapasidad, paggawa, at paggamit ay maaaring maging mahalagang palatandaan sa operasyon para sa mga investor ng CBRS habang higit pang umuunlad ang obligasyon ng OpenAI patungo sa produksyon.
Ang karagdagang opsyon na 1.25GW ng OpenAI ay nagpapakita ng potensyal na pagtaas, hindi garantisadong kita
Sa labas ng nakatakdang kapasidad, may karapatan ang OpenAI na bumili ng karagdagang 1.25GW ng Cerebras inference capacity para sa pag-deploy hanggang 2030, na maaaring palakasin ang ugnayan hanggang sa 2GW. Ang karapatan na ito ay maaaring malaki pang palawakin ang komersyal na pagkakataon kung pipiliin ng OpenAI na gamitin ito, ngunit hindi ito dapat ituring na kontratadong kita ngayon. Ang mga hinaharap na pagpapalawak ay malamang na magiging batay sa performance, ekonomiks, reliability ng pag-deploy, at mas malawak na mga pangangailangan ng infrastruktura ng OpenAI. Para sa Cerebras stock, ang ebidensya na kinukuha ng OpenAI ng karagdagang kapasidad ay maaaring palakasin ang mga inaasahang pangmatagalang demand, habang ang kakulangan ng pagpapalawak ay hindi nangangahulugang nabigo na ang umiiral na kasunduan.
Ang Dibersipikasyon ng Kliyente ay Maaaring Magbawas sa Pagkakasalalay ng CBRS sa OpenAI
Maaari pa ring maging pangunahing tagapagpabilis ng paglago ang OpenAI habang binubuo ng Cerebras ang mas malawak na batayang kliyente. Ang kumpanya ay nagsalaysay na may mga ugnayan ito sa AWS, AMD, Cognition, Lovable, CrowdStrike, Figma at iba pang mga kliyente sa enterprise, samantalang ang kanyang kita mula sa cloud at serbisyo ay umabot sa $126 milyon sa ikalawang kuwarto, tumaas ng 281% taon-taon batay sa GAAP. Ang pagpapalawak ng mga pagpapalaganap na ito ay magbibigay sa mga investor ng isa pang paraan upang masukat kung ang pangangailangan para sa inference ng Cerebra ay lumalawak pa sa isang malaking kliyente. Sa paglipas ng panahon, ang mas malakas na pagkakaiba-iba ng kita ay maaaring gawing mas mababa ang sensitibidad ng CBRS sa pagbabago sa mga desisyon ng infrastructure ng OpenAI at magbigay ng mas malinaw na ebidensya na kayang i-convert ng Cerebras ang kanyang wafer-scale technology sa mas malawak na komersyal na platform.
🔥 Labas sa Mga Balita: Ano ang Kahulugan ng KuCoin 5.0 para sa Iyo
Mabilis ang paggalaw ng mga balita sa merkado — ngunit mahalaga rin kung saan mo ito ginagamit. Sa October na ito, ilalunsad ng KuCoin ang KuCoin 5.0, na nagpapalit sa KuCoin sa isang bagong binuo na platform. Narito ang mga bagay na talagang nagbabago para sa iyo:
-
Isang account para sa lahat. Ang mga lumang platform ay naghihiwalay ang pera mo sa mga hiwalay na “spot,” “margin,” at “futures” account at inaasahan na maintindihan mo kung bakit. Ang unified account ng KuCoin 5.0 ay tinatanggal iyon — mag-deposit ng isang beses, at lahat ay nandun na (kasalukuyang available lamang sa VIPs).
-
Mga stocks, indices, at commodities. Ang KuCoin 5.0 ay lumalawak sa labas ng crypto patungo sa mga global na merkado. Kapag nagpapahinga ang crypto at umuunlad ang equities (o kaya naman ang kabaligtaran), maaari mong i-rotate sa minuto lamang, hindi kailangang buksan ang isang brokerage account at maghintay ng ilang araw para sa fiat rails.
-
Mga tunay na ari-arian (RWA). Tokenized na eksposur sa tradisyonal na ari-arian tulad ng mga komodidad, direkta sa iyong crypto account. Isa sa mga pinakamabilis na umuunlad na sektor sa pandaigdigang finansya ay hindi na eksklusibo para sa mga institusyon — ikaw ay makakapag-access dito mula sa parehong balanse na ginagamit mo para mag-trade.
-
Kita habang natututo. Hindi handa mag-trade? KCUSD ay nagpapakita ng araw-araw na kita na auto-compound sa iyong stablecoin. Ang pinakamaliit na stress na paraan upang gawing produktibo ang iyong idle deposit para sa 4% yield.
-
Isang AI assistant na nasa simpleng wika. Magtanong, makakuha ng konteksto ng merkado, unawain kung ano ang tinitingnan mo — nakabuilt sa platform, walang kailangang jargon.
-
Isang app na hindi nagdudulot ng pagkakalito. Mas mabilis, mas malinis, at mas magkakasundo — intuwitibo agad mula sa unang pag-tap, hindi pagkatapos ng tutorial.
-
Safety na maaari mong i-check, hindi lang paniwalaan. Isang EU na entidad na may lisensya sa MiCAR, Proof of Reserves na maaari mong i-verify mismo, at internasyonal na sertipikadong seguridad (SOC 2 Type II, ISO 27001:2022).
Lumikha ng iyong account sa ilang minuto — at magsimula sa platform na gawa para sa kinabukasan ng crypto, hindi sa nakaraan nito.
Kongklusyon
Ang pagbaba ng halos 20% sa stock ng Cerebras ay nagpapakita ng higit pa kaysa sa ulat ng OpenAI-Nvidia. Ang pagbukas ng mga bahagi, ang pagpapasa ng mga pagpapalabas ng pagbebenta ng mga looban, at ang kawalan ng katiyakan tungkol sa mga hinaharap na workload ng inference ay naging pambababa rin sa CBRS, habang nananatili pa rin ang mas malawak na pakikipagtulungan ni OpenAI sa Cerebras. Ang mas malaking tanong ngayon ay kung kayang palitan ng Cerebras ang kanyang wafer-scale architecture sa patuloy na komersyal na paglago habang hinahaba ni Nvidia ang pagpasok sa AI inference. Sa hinaharap, malamang na titingnan ng mga investor ang paglago ng kita, margin, pagpapalaganap ng kapasidad, pagkakaiba-iba ng mga customer, at anumang pagpapalawak sa ugnayan ni OpenAI. Dapat magbigay ang mga salik na ito ng mas malinaw na pananaw sa matagalang position ng Cerebras sa rasyo ng AI chip kaysa sa anumang isang modelo o desisyon sa hardware.
Mga Madalas na Itatanong
Ano ang Cerebras Systems?
Ang Cerebras Systems ay isang U.S.-based na kumpanya sa AI computing na kilala sa pagbuo ng wafer-scale processors na disenyo para sa mga AI workload. Ginagamit ang mga sistema nito para sa AI training at inference, at pinapahalagahan ng kumpanya ang pagbabawas ng latency sa pagbuo ng mga tugon mula sa malalaking AI models.
Ano ang stock ticker ng Cerebras?
Nagtratrade ang Cerebras Systems sa Nasdaq Global Select Market sa ilalim ng ticker na CBRS. Ang kumpanya ay naging publiko noong Mayo 14, 2026, na nagbigay ng direkta na eksposur sa mga investor sa public market sa isa sa mga emerging na kalaban ni Nvidia sa AI computing infrastructure.
Ano ang presyo ng IPO ng Cerebras?
Ipinagbili ng Cerebras ang kanyang initial public offering sa halagang $185 bawat share noong Mayo 2026. Ang natapos na pagbabenta ay naglalaman ng 34.5 milyong Class A shares at nagdala ng halos $6.38 bilyon sa kabuuang kita bago ang mga diskwento sa underwriting at iba pang gastos sa pagbabenta.
Ano ang nagiging iba sa mga chip na Cerebras kumpara sa tradisyonal na GPUs?
Ginagawa ng Cerebras ang mga processor sa paligid ng wafer-scale architecture替代 sa pagpaputol ng isang silicon wafer sa maraming mas maliit na chip. Ang disenyo nito ay naglalagay ng isang napakalaking amount ng compute, memory, at bandwidth sa isang processor, na nagpapabawas sa ilan sa paggalaw ng data sa pagitan ng mga hiwalay na chip na maaaring maging bottleneck sa malalaking AI workload.
Bakit mahalaga ang low-latency AI inference?
Ang mababang latency sa inference ay nagpapababa ng panahon sa pagitan ng hiling ng user at tugon ng AI model. Ito ay nagsisiging mas mahalaga para sa mga coding assistant, voice AI, autonomous agents at iba pang aplikasyon kung де nangangailangan ang mga user ng mga tugon sa halos real time kaysa maghintay habang natatapos ang mahabang output ng model.
Nagkakaroon ba ng ibig sabihin ang kasunduan ng OpenAI at Cerebras na ang bawat model ng OpenAI ay magpapatakbo sa Cerebras?
Hindi. Ipinaliwanag ng OpenAI ang kanilang estratehiya sa infrastraktura bilang isang portfolio ng iba’t ibang computing systems na nakatutok sa iba’t ibang workload. Kaya ang Cerebras ay maaaring magbigay ng malaking inference capacity nang hindi maging eksklusibong hardware provider para sa bawat OpenAI model, serbisyo o inference tier.
Disclaimer: Ang artikulong ito ay para sa mga layuning impormatibo lamang at hindi nagtataglay ng abiso sa pag-invest. Maaaring lubos na volatil ang mga crypto asset, at maaaring magbago nang mabilis ang mga kondisyon ng merkado, likuididad ng token, at mga pag-unlad ng proyekto. Dapat magkaroon ng sariling pag-aaral at magtaya ng kanilang kakayahan sa pagsasabik bago gumawa ng mga desisyon sa pananalapi ang mga mambabasa.
Disclaimer: AI technology ang ginamit sa pag-translate ng page na ito para sa convenience mo. Para sa pinaka-accurate na impormasyon, mag-refer sa original na English version.