

Что такое атаки на дистилляцию моделей ИИ? Как Anthropic защищает Claude
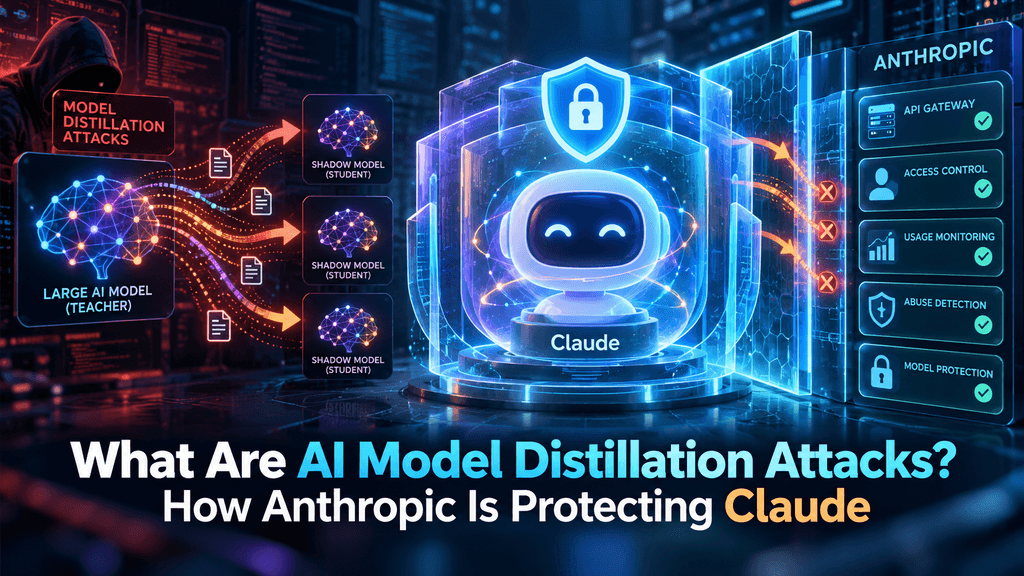
Могут ли миллионы долларов в собственных исследованиях искусственного интеллекта быть похищены просто посредством запроса к публичному API? Атаки методом дистилляции модели позволяют вредоносным субъектам систематически запрашивать передовые системы, такие как Claude, чтобы извлекать высокоинформативные пути рассуждений, схемы функций и внутреннюю логику для обучения конкурирующих систем за долю стандартных бюджетов разработки. В децентрализованных физических инфраструктурных сетях (DePIN) и экосистемах криптовалют эта угроза напрямую ставит под угрозу децентрализованные вычислительные пулы, открытые рынки интеллекта с открытым весом и инфраструктуру автономных агентов. Клонируя передовые возможности, противники подрывают токенизированные сети и средства безопасности смарт-контрактов, не финансируя фундаментальные исследования. Anthropic противостоит этой угрозе, внедряя многоуровневые системы классификации, автоматическую кластеризацию поведения, водяные знаки на выходе и динамические корректировки вывода. Этот анализ рассматривает механизмы атак методом дистилляции, их серьезные последствия для децентрализованных рынков ИИ и многоуровневую архитектуру защиты Anthropic.
Основные выводы
-
Основная концепция: Атаки на дистилляцию моделей используют публичные интерфейсы программирования для вывода для создания плотных синтетических корпусов, позволяя злоумышленникам клонировать проприетарное поведение рассуждения, обходя при этом затраты на базовые исследования.
-
Уязвимости Web3: децентрализованные экосистемы ИИ, автономные блокчейн-боты и токенизированные вычислительные сети сталкиваются с серьезными структурными рисками, когда неавторизованное дистиллирование превращает уникальные возможности моделей в товар.
-
Меры противодействия Anthropic: механизмы защиты включают анализ намерений в реальном времени, мультитенантную поведенческую телеметрию, защиту контекстуальных рассуждений и криптографическую водяную марку токенов.
-
Эксплуатация, основанная на Сибиле: кампании по извлечению данных используют децентрализованные кольца прокси, вращающиеся виртуальные платежные каналы и псевдонимные криптовалютные сети, чтобы маскировать масштабное извлечение данных под органический пользовательский трафик.
-
Смена экономики рынка: надежная защита устраняет дешевые подделки, заставляя разработчиков в традиционных технологиях и секторе Web3 инвестировать напрямую в аутентичные базовые наборы данных и проверяемые выводы.
Что такое атаки на дистилляцию моделей ИИ?
Механика: как извлечение использует интерфейсы моделей
Атаки на дистилляцию моделей используют обычный доступ к API для сбора собственнической интеллектуальной собственности и копирования передовых возможностей. Создание передовых моделей требует сотен миллионов долларов на выделенные аппаратные кластеры, отточенные синтетические конвейеры и обширное обучение с подкреплением. В отличие от этого, злоумышленник запускает автоматизированные пакеты запросов в специализированных областях, собирает полные ответы целевой модели и использует эту структурированную информацию для тонкой настройки меньших архитектур с открытыми весами. Этот процесс обходит капиталоемкие и инженерные барьеры, определяющие современную разработку машинного обучения.
Атака нацелена на стандартные интерфейсы генерации текста. Поскольку продвинутые системы спроектированы для предоставления четких и подробных разборов задач при ответах на программные или математические запросы, они случайно выдают точные инструкционные сигналы, необходимые для обучения моделей имитации. Злоумышленник отправляет сложные логические задачи, записывает промежуточные этапы рассуждений и формирует плотный обучающий корпус. При вводе в меньшую целевую модель эта отобранная информация позволяет системе имитации достигать показателей на уровне эталонных результатов, затрачивая менее одного процента от первоначальных вычислительных ресурсов. Поскольку запросы похожи на легитимные запросы разработчиков, традиционные периметральные системы защиты не распознают извлечение.
Использование синтетических данных и извлечение логических выводов
Извлечение промежуточных следов рассуждений значительно ускоряет имитационное обучение по сравнению со стандартной безнадзорной предварительной подготовкой. Злоумышленники сосредотачиваются на областях с высоким кредитным плечом, таких как автоматизированная аудит смарт-контрактов, теоретико-игровые переговоры, арбитраж на децентрализованных биржах и символическая математика. Посылая запросы, специально разработанные для принуждения к пошаговой логике, злоумышленник превращает целевую платформу в автоматический генератор наборов данных.
-
Извлечение цепочки рассуждений: сбор промежуточных шагов решения задач для выделения когнитивных рабочих процессов в сети несогласованных или неавторизованных получателей.
-
Использование инструментов и кража схем: захват структур вызовов функций, структурированных JSON-выходов и процедур восстановления для обучения автономных агентов выполнения.
-
Пробивание границ безопасности: систематическая оценка защитных механизмов для картирования фильтров модерации и обучения вторичных моделей, обходящих стандартные протоколы согласованности.
Топологии атак: распределенные кампании по извлечению
Современные кампании по дистилляции используют распределенную инфраструктуру, а не изолированные клиенты, чтобы избежать ограничений по объему. Эти операции полагаются на пулы прокси, вращающиеся профили идентичности и многоарендную хостинговую среду для имитации разнообразных моделей взаимодействия розничных пользователей.
| Вектор атаки | Механизм развертывания | Целевой актив | Сложность обнаружения |
| Скоординированные пулы запросов | Распределённые ботнеты, меняющие ключи доступа клиентов | Глубокие математические доказательства, логика смарт-контракта | Высокий |
| Симулированные розничные запросы | Парфразированные варианты стандартных академических эталонов | Специализированные отраслевые знания для институциональных клиентов | Очень высокий |
| Автономные агентные циклы | Самоорганизующиеся конвейеры, выполняющие многоэтапные задачи | Схемы исполнения, коррекции ошибок в реальном времени | Экстремальный |
| Враждебные пограничные проверки | Автоматизированное тестирование границ охранных барьеров | Операционные лимиты безопасности, базовые уровни модерации | Умеренный |
Эти распределенные сети часто используют криптовалютные сети для обеспечения анонимности. Злоумышленники финансируют ключи доступа с помощью виртуальных платежных провайдеров, пополняемых децентрализованными активами, разрывая связи верификации личности, используемые платформами корпоративного облачного сервиса. В результате кампании по извлечению сливаются с нормальным ростом трафика, а не выглядят как скоординированные операции.
Пересечение с Web3 и криптовалютой
Векторы угроз против DePIN и децентрализованных вычислений
Дистилляция моделей представляет собой непосредственную экономическую проблему для сетей искусственного интеллекта Web3 и децентрализованных физических инфраструктурных систем. Сети DePIN координируют распределенные кластеры оборудования для обучения, оценки и размещения моделей с помощью токен-стимулов. Когда модели, размещенные на открытых нодах, систематически копируются с помощью неавторизованной дистилляции, внутренняя стоимость, поддерживающая нативные утилитарные токены, снижается.
Если доступ к узлам децентрализованной модели позволяет создавать локальные клоны с собственным хостингом, спрос на натуральное стейкинг и утилитарные токены снижается. Дистилляция превращает вычислительные результаты в товар до того, как сети смогут обеспечить стабильный доход от комиссий. Например, если экосистема тратит средства казны на создание специализированного блокчейн-аналитического движка, противник может за несколько дней извлечь эти возможности рассуждения, развернуть идентичную модель на альтернативной сети, снизить цены и ослабить рыночную позицию оригинального проекта.
Уязвимости в смарт-контрактах и безопасность на цепочке
Автономные агенты, использующие передовые модели для оптимизации доходности, управления ликвидностью и оценки смарт-контрактов, сталкиваются с серьезным дублированием операций. Злоумышленники отслеживают деятельность агентов, чтобы выделить стратегии выполнения, параметры риска и механизмы проверки.
-
Репликация стратегии: Конкуренты копируют автономные алгоритмы маркет-мейкинга, захватывая рамки принятия решений, генерируемые агентами, основанными на передовых подходах.
-
Ускорение эксплуатации: склонированные модели, обученные на извлеченных методах безопасности, позволяют злоумышленникам проводить оффлайн-сканирование уязвимостей, выявляя недостатки контрактов без передачи активности в публичные реестры.
-
Сибилловские финансовые петли: нерегулируемые субъекты используют конфиденциальные кошельки и децентрализованные финансовые инструменты для финансирования кластеров скрапинга, обходя процедуры проверки клиента.
Прерывание стейкинга в децентрализованном машинном обучении
Экономическая безопасность стейкнутых AI-сетей основана на предпосылке, что создание высококачественного интеллекта требует значительных затрат ресурсов. В системе машинного обучения с доказательством владения акциями операторы нод размещают залог для гарантии точных, вычислительно интенсивных результатов.
Дистилляция нарушает этот баланс стимулов. Злонамеренный оператор может дистиллировать проприетарную модель в легковесную имитационную архитектуру, запустить эту копию на недорогом потребительском оборудовании и отправлять её выходные данные в сеть. Поскольку имитация соответствует стандартным критериям проверки, оператор получает полные вознаграждения за валидацию, понесев лишь долю затрат на вычисления по сравнению с легитимными участниками. Такая динамика наказывает честных операторов, которые поддерживают специализированную корпоративную инфраструктуру, способствуя централизации сети и подрывая доверие к децентрализованному протоколу.
Как Anthropic защищает Claude
Динамическая двухэтапная классификация намерений
Anthropic применяет двухэтапную классификационную систему для перехвата запросов на извлечение до их преобразования в обучающие данные. Вместо использования простых черных списков ключевых слов запросы анализируются по семантическим, синтаксическим и структурным параметрам.
На первом этапе проводится структурно-семантическое профилирование. Классификатор оценивает, проявляет ли входящий запрос признаки программной генерации набора данных — такие как повторяющиеся перестановки или структуры академических тестов — а не естественное использование разработчиками. На втором этапе в реальном времени отслеживаются динамика выдачи токенов ответа, чтобы перехватить запросы, предназначенные для извлечения скрытых рассуждений. При обнаружении высокой вероятности извлечения платформа запускает динамическую корректировку ответа, предоставляя прямой ответ, но скрывая промежуточные следы рассуждений, необходимые злоумышленникам для тонкой настройки.
Многотенантная поведенческая телеметрия и кластеризация
Чтобы выявить распределенные клиентские кольца, Anthropic сопоставляет поведенческие телеметрические данные между, казалось бы, независимыми аккаунтами пользователей. Поскольку дистилляция требует огромных объемов данных, кампании по сбору данных порождают обнаруживаемые статистические корреляции в сети.
Когда разрозненные аккаунты в различных IP-пространствах и с различными методами оплаты демонстрируют параллельные поведенческие ритмы, платформа фиксирует эту корреляцию. Телеметрический движок оценивает совпадающие шаблоны синтаксиса запросов, синхронизированные запросы токенов и дополнительные исследования доменов. Если тысячи независимых аккаунтов запрашивают варианты идентичных программных задач в сдвинутых последовательностях, система относит их к скоординированной операции. Anthropic затем применяет скоординированные корректировки лимитов, детальное логирование и одновременное отключение доступа для разрушения сети.
Защита окна контекста
Установленный метод дистилляции включает манипуляцию контекстом, при котором злоумышленники вставляют предыдущие шаги рассуждений модели обратно в новые запросы, чтобы заставить ее непрерывно раскрывать техническую информацию.
Anthropic устранила эту уязвимость, переработав механизмы обработки контекста. Система реализует строгий отслеживание происхождения всех токенов в пределах окна контекста, различая внешний пользовательский ввод, предыдущую историю генерации и защищенные элементы рассуждений. Когда пользователь вводит ранее сгенерированные следы рассуждений для принудительного раскрытия информации, модель распознает враждебный паттерн и прекращает выполнение этого пути, блокируя использование длинных окон контекста в качестве векторов извлечения.
Криптографическая и статистическая водяная марка вывода
Anthropic использует статистическую водяную марку для встраивания проверяемых структурных паттернов в выходные последовательности, обеспечивая математическое доказательство происхождения без ущерба для ясности, плавности или технической точности.
Базовая техника использует псевдослучайные корректировки частоты токенов. Генерирующий движок тонко придает приоритет определенным синонимичным токенам на основе внутреннего криптографического ключа. Хотя вывод выглядит естественно для человеческих читателей, статистический анализ больших наборов данных, сгенерированных подозреваемой клонированной моделью, позволяет определить, обучалась ли она на выходных данных Claude. Такое определение происхождения предоставляет действенные доказательства для подачи претензий на интеллектуальную собственность, удаления неавторизованных моделей из открытых репозиториев и недействительности незаконных сервисов в децентрализованных сетях.
Экономические меры противодействия
Самая устойчивая защита от дистилляции моделей нарушает финансовые расчеты атакующего. Дистилляция возможна только тогда, когда запрос к API значительно дешевле, чем самостоятельная разработка модели. Anthropic согласовывает технические меры защиты с экономическими санкциями.
| Защитный слой | Операционная направленность | Стратегический результат |
| Двухэтапный классификатор | Семантический анализ в реальном времени | Нейтрализует запросы на извлечение до генерации |
| Поведенческая кластеризация | Корреляция паттернов между аккаунтами | Разрушает распределенные ботнеты для скрапинга |
| Защита контекста | Отслеживание происхождения токенов | Предотвращает извлечение инъекций в запрос |
| Статистические водяные знаки | Корректировки частоты криптографических токенов | Обеспечивает проверяемое указание источника украденных данных |
Когда классификаторы намерений выявляют попытку извлечения данных и переключаются на краткие ответы, платформа обрабатывает запрос по стандартным тарифам. Кроме того, когда поведенческое фингерпринтинг подтверждает наличие распределенного кольца извлечения, связанные аккаунты закрываются, а предварительно пополненные балансы конфискуются за нарушение условий обслуживания. Оплата невыгодных обучающих данных при нейтрализации операционных аккаунтов делает масштабное извлечение экономически нецелесообразным.
Стратегические последствия для криптовалютного и ИИ-рынков
Изменяющаяся экономика машинного обучения
Внедрение эффективных защит от дистилляции меняет экономическую модель разработки ИИ как в традиционных вычислительных системах, так и в децентрализованных протоколах. По мере того как передовые платформы ограничивают утечки синтетических обучающих данных, создание высокопроизводительных моделей снова требует реальных вычислительных ресурсов, архитектурных инноваций и проверенных наборов данных.
Этот переход ускоряет консолидацию капитала в протоколах децентрализованного интеллекта. Команды больше не могут поддерживать ценность, упаковывая отфильтрованные результаты в открытые обертки. Децентрализованные инициативы должны инвестировать в фундаментальные исследования, криптографически подтвержденные отзывы людей и специализированную инфраструктуру. Рынки цифровых активов отражают этот сдвиг, перераспределяя капитал от деривативных оберток к фундаментальным протоколам, которые демонстрируют доказуемую аутентичность обучения и устойчивые архитектуры моделей.
Укрепление экосистем с открытыми весами
Граница между открытыми исследовательскими данными и проприетарной информацией определяется тем, как управляется происхождение данных. Модели с открытыми весами, обученные на проверенных открытых наборах данных, остаются важными для прозрачных и децентрализованных систем. Однако системы, зависящие от неавторизованного дистиллирования, подвержены внезапным сбоям из-за мер, принимаемых на уровне платформ, и регуляторных рисков.
Веб-3 организации, объединяющие машинное обучение и блокчейн-инфраструктуру, должны создавать проверяемые конвейеры данных. Развертывание моделей, содержащих обнаруживаемые водяные знаки, подвергает децентрализованные протоколы операционным и юридическим рискам, включая исключение из крупных хабов ликвидности и интеграций с институциональными децентрализованными финансовыми системами. Проекты внедряют строгие рамки аудита данных для подтверждения того, что их обучающие ресурсы не нарушают права на собственность.
Проверяемые выводы и доказательства с нулевым разглашением
По мере роста рисков, связанных с дистилляцией и заменой моделей, криптовалютные протоколы внедряют проверяемые механизмы вывода на основе машинного обучения с нулевым разглашением (zkML). Доказательства с нулевым разглашением позволяют децентрализованной ноде математически доказать, что вывод был вычислен с использованием конкретной, подлинной модели, не раскрывая при этом базовые параметры или конфиденциальные входные данные.
Эта криптографическая проверка гарантирует, что ноды запускают подлинные модели, а не легковесные дистиллированные имитации, созданные для нечестного получения вознаграждений. Требуя криптографические доказательства выполнения, децентрализованные сети обеспечивают получение пользователями подлинной интеллектуальной информации. Хотя zkML проверяет точность выполнения в цепочке, защита поставщиков передовых решений охраняет начальную разработку модели, образуя интегрированную границу безопасности для развивающейся автономной цифровой экономики.
Заключение
Атаки на дистилляцию ИИ представляют собой расчетный вектор извлечения, нацеленный на собственную интеллектуальную собственность, децентрализованные вычислительные сети и автономные системы Web3. Путем выполнения автоматизированных масштабных кампаний запросов злоумышленники пытаются обойти фундаментальные затраты на обучение и воспроизвести передовые возможности рассуждения с низкими расходами. Anthropic решает эту проблему с помощью интегрированной архитектуры защиты, объединяющей динамическую классификацию намерений, кластеризацию поведения с многопользовательским доступом, обеспечение происхождения контекста и криптографическую водяную марку вывода. В системах децентрализованных финансов и DePIN, где автономное принятие решений требует надежной, неподверженной компромиссам интеллектуальной базы, эти защитные системы обеспечивают устойчивость протоколов и предотвращают обесценивание вычислительных стимулирующих токенов. По мере развития сектора машинного обучения в течение 2026 года операционный фокус будет сосредоточен на защите весов моделей, обеспечении проверяемого вывода и сертификации происхождения данных, питающих автономные программные сети.
🔥 За кулисами новостей: что значит KuCoin 5.0 для вас
Новости рынка движутся быстро — но то, где вы на них реагируете, имеет не меньшее значение. В этом октябре KuCoin запускает KuCoin 5.0, превращая KuCoin в перестроенную платформу. Вот что реально изменится для вас:
-
Один аккаунт для всего. Старые платформы разделяли ваши средства между отдельными аккаунтами «спот», «маржа» и «фьючерсы» и ожидали, что вы поймете почему. Единый аккаунт KuCoin 5.0 полностью устраняет это — сделайте депозит один раз, и всё будет просто доступно (на данный момент доступно только для VIP-пользователей).
-
Акции, индексы и товары. KuCoin 5.0 расширяется за пределы криптовалют на глобальные рынки. Когда криптовалюты движутся боком, а акции растут (или наоборот), вы переключаетесь за минуты, вместо того чтобы открывать брокерский аккаунт и ждать несколько дней для вывода фиата.
-
Реальные активы (RWA). Токенизированная экспозиция к традиционным активам, таким как сырьевые товары, прямо в вашем криптоаккаунте. Один из самых быстрорастущих сегментов мировой финансовой системы больше не доступен исключительно институциональным инвесторам — вы получаете к нему доступ с того же баланса, который используете для торговли.
-
Зарабатывайте, пока учитесь. Еще не готовы торговать? KCUSD позволяет вашим стейблкоинам получать ежедневный автокомпаундный доход. Самый спокойный способ заставить ваши неиспользуемые депозиты работать с доходностью 4%.
-
Искусственный интеллект на простом языке. Задавайте вопросы, получайте контекст рынка, понимайте, что вы видите — всё встроено в платформу, без жаргона.
-
Приложение, которое не перегружает. Быстрее, чище и последовательно — интуитивно понятно с первого касания, а не после обучения.
-
Безопасность, которую можно проверить, а не просто доверять. Европейская компания с лицензией MiCAR, Proof of Reserves , которую вы можете проверить самостоятельно, и международно сертифицированная безопасность (SOC 2 Type II, ISO 27001:2022).
Создайте аккаунт за несколько минут — и начните работать на платформе, созданной для того, куда движется криптовалюта, а не туда, где она была.
ЧаВо
В чем техническое различие между тонкой настройкой модели и дистилляцией модели?
Тонкая настройка изменяет внутренние параметры существующей базовой модели с использованием целевых наборов данных для оптимизации её производительности для конкретных задач. Дистилляция передаёт возможности и методы рассуждений огромной учительской модели в совершенно отдельную ученическую модель путём обучения ученика на выходных данных, сгенерированных учителем.
Могут ли противники удалить статистические водяные знаки в выходных данных модели?
Водяные знаки могут быть ослаблены за счет вторичного перефразирования, семантического перемешивания или объединения выходных данных из нескольких различных архитектур. Однако полное удаление многобитовых статистических водяных знаков, как правило, снижает точность рассуждений и синтаксическую структуру, а основные математические сигнатуры остаются обнаруживаемыми в больших обучающих наборах данных.
Классифицируются ли все формы генерации синтетических данных как атаки методом дистилляции?
Нет. Генерация синтетических данных представляет собой атаку путем дистилляции только в случае нарушения обязательных условий обслуживания провайдера API, обхода систем контроля доступа или намеренного извлечения собственных маршрутов рассуждений без разрешения с целью воспроизведения коммерческих возможностей в конкурирующих моделях.
Как связаны доказательства с нулевым разглашением с дистилляцией моделей в публичных блокчейнах?
Машинное обучение с нулевым разглашением подтверждает, что выход был сгенерирован конкретной архитектурой модели, не раскрывая веса модели или частные входные данные. Хотя оно гарантирует целостность выполнения и предотвращает тайную замену операторами ноды дистиллированных копий, оно не препятствует авторизованному пользователю использовать проверенные выходные данные для обучения модели вне цепочки.
Приводит ли чрезмерная дистилляция к ухудшению производительности имитационных моделей?
Да. Системы, обученные исключительно на синтетических выходных данных, часто страдают от коллапса модели и накопления галлюцинаций. Без опоры на широкие первичные обучающие корпусы и человеческую валидацию клонированные модели испытывают трудности при работе с новыми задачами и не справляются при столкновении со сложными задачами за пределами их узких обучающих примеров.
Отказ от ответственности: Эта статья предназначена исключительно для информационных целей и не является финансовой или инвестиционной консультацией. Инвестиции в криптовалюты сопряжены со значительными рисками. Всегда проводите собственное исследование перед торговлей.
Отказ от ответственности: Эта страница была переведена для вашего удобства с использованием технологии искусственного интеллекта. Для получения наиболее точной информации обратитесь к оригинальной английской версии.