

Les actions de Cerebras chutent de 20 % après qu'OpenAI se tourne vers les puces Nvidia : ce que cela signifie pour la course aux puces IA
Cerebras Systems est entré dans le champ des observateurs après que l'action CBRS a chuté de près de 20 % à la fin septembre et au début octobre 2026. Ce recul a suivi des rapports selon lesquels OpenAI utilisait des GPU Nvidia pour une charge de travail GPT-6.1 Sol Ultrafast, soulevant de nouvelles questions sur la concurrence sur le marché des puces IA. La vente a également été influencée par la libération d'actions post-OPC et les déclarations de ventes internes. OpenAI n'a pas mis fin à son partenariat avec Cerebras, donc la question clé est de savoir si Nvidia peut défier directement Cerebras dans l'inférence IA à faible latence.
Pourquoi le cours de Cerebras a-t-il chuté de près de 20 % ?
Les actions de Cerebras ont subi une forte pression à la fin septembre et au début octobre 2026, passant de 206,75 $ le 25 septembre à 166,43 $ le 2 octobre. Cela représente une baisse d'environ 19,5 %, faisant descendre CBRS en dessous de son prix d'IPO de 185 $. Le mouvement le plus marqué s'est produit le 30 septembre, lorsque les actions ont chuté de 8,87 %. Bien que les rapports liant la dernière charge de travail IA ultra-rapide d'OpenAI à Nvidia soient devenus le principal catalyseur technologique, le désinvestissement n'a pas été provoqué par un seul événement. Un déblocage d'actions post-IPO programmé et des déclarations de vente par des insiders sont arrivés à peu près en même temps, ajoutant une autre source de pression vendeuse et d'incertitude autour de l'action. Cette combinaison a rendu plus difficile pour les investisseurs de distinguer les préoccupations concernant la position concurrentielle de Cerebras des dynamiques de marché post-IPO ordinaires. Cette distinction est importante car la baisse d'environ 20 % reflète plusieurs pressions superposées plutôt qu'un changement confirmé dans la stratégie d'OpenAI.
Le rapport OpenAI-Nvidia a soulevé des questions sur le rôle de Cerebras en matière d'inférence
La principale préoccupation nouvelle est apparue après que SemiAnalysis ait rapporté que la charge de travail GPT-6.1 Sol Ultrafast d'OpenAI était gérée sur des GPU Nvidia plutôt que sur du matériel Cerebras. Cela avait de l'importance car Cerebras avait déjà établi un rôle visible dans la stratégie d'inférence à haute vitesse d'OpenAI. En août, OpenAI avait confirmé que GPT-5.6 Sol Ultrafast était alimenté par Cerebras et pouvait fournir des vitesses de sortie allant jusqu'à environ 750 jetons par seconde. Les investisseurs avaient donc des raisons de surveiller si Cerebras continuerait à alimenter les générations ultérieures des produits d'inférence les plus rapides d'OpenAI. Si Nvidia peut offrir des performances compétitives sur des charges similaires, cela pourrait remettre en question l'hypothèse selon laquelle Cerebras dispose d'un avantage clair dans chaque déploiement d'inférence à très faible latence. Cette possibilité suffit à soulever des questions sur la part de la demande future d'inférence d'OpenAI que Cerebras pourrait finalement capter.
Le rapport ne signifiait pas qu’OpenAI avait mis fin à sa relation avec Cerebras. OpenAI s’appuie depuis longtemps fortement sur les GPU Nvidia, tout en développant un portefeuille de calcul plus vaste qui inclut Cerebras et d’autres fournisseurs. Plus important encore, OpenAI n’a pas annoncé l’annulation de son accord de 750 MW avec Cerebras, et Sam Altman a ensuite décrit Cerebras comme un partenaire étroit. La réaction du marché semble refléter une préoccupation plus limitée : si Nvidia peut concurrencer efficacement pour les mêmes charges de travail à faible latence où Cerebras a mis en avant un avantage en vitesse, Cerebras pourrait faire face à une concurrence plus forte pour les futurs déploiements d’inférence d’OpenAI que certains investisseurs ne l’avaient anticipé. Cela n’éliminerait pas nécessairement Cerebras de l’infrastructure d’OpenAI, mais pourrait modifier la manière dont les investisseurs perçoivent la part future de l’entreprise dans les charges de travail d’inférence à haute valeur. Pour une entreprise de puces IA nouvellement cotée qui doit encore démontrer l’échelle de ses opportunités commerciales, même un changement perçu dans l’attribution des clients peut avoir un effet disproportionné sur le sentiment.
Le partage débloque une pression supplémentaire sur le titre CBRS
L'histoire d'OpenAI-Nvidia est intervenue au moment où un grand bloc d'actions de Cerebras est devenu éligible à la vente suite à son IPO. Vers le 30 septembre, environ 19,4 millions d'actions ont été libérées des restrictions de blocage, avec des tranches supplémentaires prévues pour octobre. Plusieurs déclarations de ventes par des insiders sont également apparues durant la même période. Ces événements ne prouvent pas que toutes les actions libérées ont été vendues immédiatement, mais ils ont augmenté l'offre potentielle d'actions CBRS sur le marché. Pour une action récemment entrée en bourse, la perspective de nouvelles actions négociables peut peser sur le prix lorsque le sentiment des investisseurs s'affaiblit déjà. Pris ensemble, le rapport Nvidia, l'incertitude concernant le futur rôle de Cerebras dans les charges de travail d'inférence les plus rapides d'OpenAI et le déblocage post-IPO des actions fournissent une explication plus complète de la chute de près de 20 % du cours de Cerebras sur plusieurs sessions de négociation. La baisse semble donc moins être une réaction à un seul catalyseur et davantage le résultat d'inquiétudes concurrentielles, d'une pression sur l'offre et de changements dans les attentes concernant l'histoire de croissance de Cerebras.
Le changement d'OpenAI vers Nvidia et ce qu'il signifie pour Cerebras
Le problème plus important pour Cerebras n’est pas simplement que Nvidia pourrait être impliquée dans l’un des nouveaux chargements d’inférence à haute vitesse d’OpenAI. La question plus cruciale est de savoir si Nvidia peut désormais concurrencer plus efficacement le segment de l’inférence à faible latence que Cerebras a utilisé pour se démarquer des systèmes traditionnels basés sur des GPU. Cerebras a construit une grande partie de sa justification commerciale autour de son architecture à échelle de puce, de la large bande passante mémoire intégrée sur puce et de sa capacité à générer des jetons à très haute vitesse sans compter sur de grands clusters de GPU séparés. Si Nvidia peut réduire cet écart de performance tout en offrant aux clients un écosystème logiciel familier et une base d’infrastructure installée bien plus importante, Cerebras devra peut-être prouver son avantage charge par charge, plutôt que de compter uniquement sur la vitesse brute d’inférence.
Cela ne rend pas Cerebras irrélevant pour la stratégie d’infrastructure d’OpenAI. OpenAI adopte de plus en plus une approche multi-fournisseurs pour le calcul AI, utilisant différents matériels pour l’entraînement, l’inférence et les charges de travail spécialisées en fonction du coût, de la disponibilité et des performances. Cerebras peut toujours bénéficier de ce modèle si ses systèmes restent particulièrement compétitifs pour l’inférence sensible à la latence. Le défi stratégique est qu’OpenAI dispose désormais de davantage d’options. Au lieu qu’un seul fournisseur domine chaque étape du déploiement de modèles, l’infrastructure IA future pourrait être répartie entre les GPU Nvidia, les systèmes wafer-scale de Cerebras et d’autres accélérateurs spécialisés, chaque plateforme remportant les charges de travail où son architecture offre les meilleures économies ou performances.
Cerebras doit démontrer un avantage au-delà de la vitesse brute d'inférence
Cerebras a attiré l'attention car son Wafer-Scale Engine adopte une approche très différente de l'architecture GPU utilisée par Nvidia. Plutôt que de connecter un grand nombre de puces accélératrices distinctes, Cerebras intègre un nombre énorme de cœurs de calcul sur un seul processeur à échelle de puce. Ce design peut réduire les goulots d'étranglement de communication et est particulièrement utile pour les charges de travail où la latence est cruciale. Pour les clients qui exécutent des assistants IA interactifs, des modèles de codage ou des applications d'inférence en temps réel, une génération plus rapide de jetons peut améliorer directement l'expérience utilisateur.
Cependant, les acheteurs d’infrastructure IA évaluent bien plus que les jetons par seconde. Le coût total de possession, l’efficacité énergétique, la compatibilité avec les modèles, les outils de développement, la flexibilité de déploiement et l’accès à la capacité disponible peuvent tous influencer les décisions d’achat. L’écosystème logiciel CUDA de Nvidia reste profondément ancré dans l’industrie de l’IA, tandis que ses systèmes de génération Blackwell sont conçus pour servir à la fois des charges de travail d’inférence à haut débit et de plus en plus sensibles à la latence. Cerebras doit donc démontrer que ses avantages architecturaux se traduisent par des coûts inférieurs ou des performances d’application nettement supérieures à l’échelle commerciale. Cette comparaison deviendra de plus en plus importante alors que les entreprises d’IA passent de l’entraînement de modèles plus grands à la diffusion efficace de ces modèles à des millions d’utilisateurs.
La stratégie multi-puces d'OpenAI pourrait encore laisser de la place à Cerebras
L'expansion de l'infrastructure d'OpenAI suggère que la course aux puces IA est peu susceptible de devenir un simple concours où le vainqueur emporte tout. Les grands développeurs d'IA nécessitent d'énormes montants de calcul, et compter sur un seul fournisseur de matériel peut créer des contraintes en termes de capacité, de prix et de chaîne d'approvisionnement. Utiliser plusieurs architectures de puces donne à OpenAI plus de flexibilité pour associer différents modèles et charges de travail à l'infrastructure qui performe le mieux pour chaque tâche. Cette approche peut également réduire la dépendance à tout fournisseur unique alors que la demande en inférence IA continue de croître.
Pour Cerebras, cela signifie que l'opportunité clé n'est pas nécessairement de remplacer Nvidia sur l'ensemble de la pile d'infrastructure d'OpenAI. Un chemin de croissance plus réaliste consiste à obtenir une part significative des charges de travail d'inférence spécialisées où la vitesse et la faible latence justifient l'utilisation d'une architecture différente. Sa position à long terme dépendra de sa capacité à transformer ces avantages techniques en déploiements répétables chez OpenAI et d'autres clients. La capacité de l'entreprise à diversifier au-delà d'un petit nombre de clients majeurs comptera également, car une adoption plus large rendrait son activité moins sensible aux changements dans la façon dont une entreprise d'IA répartit ses ressources informatiques entre les différents fournisseurs de puces concurrentes.
Cerebras contre Nvidia dans la course croissante aux puces d'inférence IA
La comparaison entre Cerebras et Nvidia devient de plus en plus pertinente alors que les entreprises d'IA dépensent davantage pour l'inférence, la phase où les modèles entraînés génèrent des réponses, du code, des réponses vocales et des actions d'agents pour les utilisateurs. Cerebras et Nvidia abordent ce marché différemment : Cerebras se concentre sur le traitement à l'échelle des wafers et une génération de jetons à très faible latence, tandis que Nvidia combine des GPU puissants, un réseau à haute vitesse et un écosystème logiciel mature pour prendre en charge des charges de travail IA à grande échelle. Cela signifie que la course aux puces d'inférence IA ne se résume pas simplement à savoir quel processeur est le plus rapide. Le coût par jeton, le débit, la latence, l'efficacité énergétique, la prise en charge des modèles et la facilité de déploiement peuvent tous influencer le matériel qu'une entreprise d'IA choisit pour une charge de travail particulière.
Cerebras contre Nvidia pour l'inférence IA : différences clés
Cerebras construit sa plateforme d'inférence autour du Wafer-Scale Engine, qui intègre un très grand nombre de cœurs de calcul sur un seul processeur et est conçu pour réduire les goulots d'étranglement en communication et en mémoire qui peuvent ralentir l'inférence IA. Nvidia adopte une approche plus modulaire, reliant un grand nombre de GPU à l'aide de technologies telles que NVLink et les couplant à son écosystème logiciel CUDA. Cela confère à Nvidia une flexibilité accrue dans les déploiements d'entraînement, d'inférence et de centre de données, tandis que Cerebras se distingue davantage par son accent sur des temps de réponse rapides et des performances d'inférence spécialisées. Comparer les deux exige donc d'examiner l'architecture et la stratégie de déploiement, plutôt que de s'appuyer uniquement sur un seul indicateur de tokens par seconde.
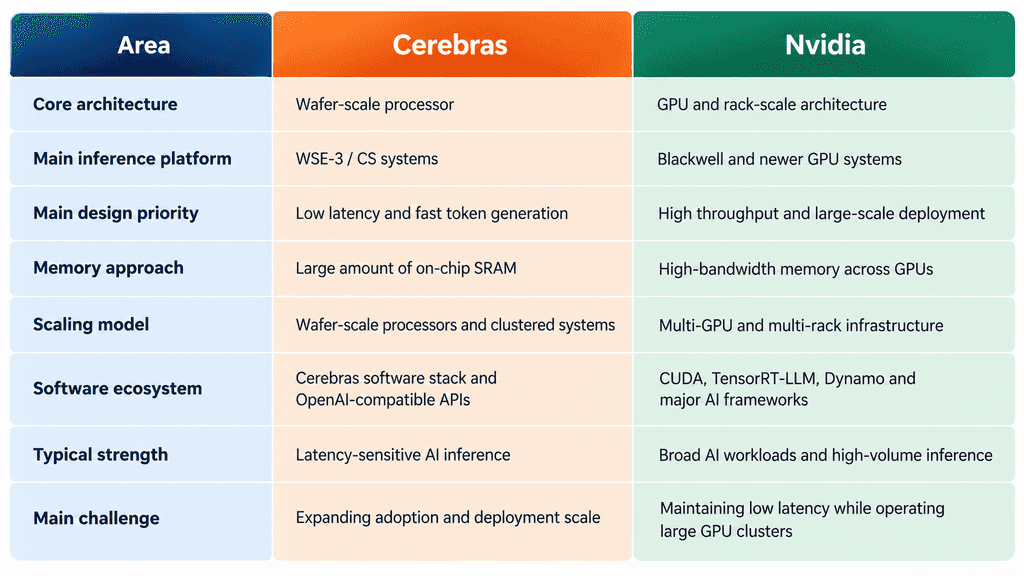
L'économie de l'inférence IA pourrait être plus importante que la vitesse brute
Alors que l'utilisation de l'IA augmente, les acheteurs d'infrastructure se concentrent de plus en plus sur la quantité d'inférence utile qu'ils peuvent fournir pour chaque dollar et chaque unité d'énergie consommée. Une plateforme qui produit des réponses extrêmement rapides peut être précieuse pour les assistants de codage, les agents IA en temps réel et les applications interactives, mais les fournisseurs gérant des milliards de jetons peuvent accorder plus d'importance au débit, à l'utilisation et au coût par jeton. Nvidia a de plus en plus mis l'accent sur ces métriques avec ses systèmes de génération Blackwell, affirmant que les nouvelles plateformes peuvent traiter davantage de charges de travail d'inférence tout en améliorant l'efficacité énergétique et en réduisant les coûts de service par rapport aux matériels Nvidia antérieurs.
Cerebras s'approche des mêmes économies par une autre voie. Son architecture est conçue pour garder davantage de données de modèle à proximité des cœurs de calcul, ce qui peut réduire les déplacements de mémoire et améliorer la vitesse de génération de jetons. L'entreprise a également exploré l'inférence désagrégée, où différents matériels gèrent différentes étapes du processus d'inférence plutôt que d'imposer à un seul type de processeur d'effectuer toutes les tâches. Ce modèle pourrait devenir plus courant alors que les entreprises d'IA cherchent la combinaison de matériel la plus efficace pour le pré-remplissage, le décodage et le raisonnement sur de longs contextes.
Le marché plus large de l’inférence IA pourrait donc devenir de plus en plus hétérogène plutôt que dominé par une seule architecture. Nvidia bénéficie d’un écosystème logiciel étendu, d’une grande base installée et d’un large soutien à la fois pour l’entraînement et l’inférence, tandis que Cerebras cherche à établir une position plus forte sur les charges de travail où le temps de réponse est particulièrement important. À mesure que les modèles de raisonnement et AI agents deviendront plus exigeants sur le plan computationnel, l’avantage concurrentiel dépendra peut-être moins d’un seul benchmark et davantage de la plateforme qui offrira le meilleur équilibre entre latence, débit, consommation d’énergie et coût par token à l’échelle commerciale.
Comment le partenariat avec OpenAI pourrait influencer le cours de Cerebras à venir
Pour les actions de Cerebras, la relation avec OpenAI risque de moins importe en tant que partenariat médiatique et davantage par des résultats financiers mesurables. Les investisseurs peuvent désormais observer si la capacité d'inférence contractée se transforme en revenus selon le planning, si Cerebras peut construire l'infrastructure nécessaire pour respecter ses engagements, et si OpenAI élargit finalement son utilisation de la plateforme. Ces jalons pourraient avoir une influence plus importante sur la stratégie d'investissement à long terme de CBRS que les changements à court terme concernant quel puce alimente un modèle ou un service individuel.
Les revenus d'OpenAI pourraient devenir une partie plus importante de l'histoire de croissance de Cerebras
Cerebras a commencé à reconnaître les revenus provenant de son accord avec OpenAI au premier trimestre 2026 et a enregistré 56,8 millions de dollars provenant de cet accord au deuxième trimestre, portant les revenus du premier semestre liés à cet accord à 74,4 millions de dollars. Au 30 juin, Cerebras a déclaré un montant de 25,4 milliards de dollars en obligations de performance restantes, une grande partie étant liée à OpenAI, et a indiqué qu'environ 22 % de ce montant devrait être reconnu au cours des 24 mois se terminant en juin 2028. Pour les investisseurs, la question clé est donc la conversion des revenus : une croissance constante provenant de ces obligations contractuelles permettrait à Cerebras d'avoir une meilleure visibilité sur les ventes futures, tandis que des retards de déploiement ou une reconnaissance plus lente pourraient exercer une pression sur les attentes.
L'extension de la capacité mettra à l'épreuve la capacité de Cerebras à livrer à grande échelle
La taille de l'accord avec OpenAI crée également un défi d'exécution. Cerebras a indiqué disposer de plus de 600 MW de capacité de centre de données en ligne ou sous contrat pour livraison d'ici la fin de 2027, tandis que la capacité de fabrication devait augmenter de plus de dix fois au cours de l'année 2026. L'entreprise a également sécurisé une fourniture supplémentaire de wafers de TSMC alors qu'elle se prépare à une demande accrue. Ces investissements sont importants car Cerebras doit transformer sa technologie en infrastructure commerciale fiable à travers plusieurs centres de données. Les progrès en matière de déploiement de capacité, de fabrication et d'utilisation pourraient donc devenir des indicateurs opérationnels importants pour les investisseurs de CBRS à mesure que plus de l'engagement d'OpenAI se concrétise en production.
L'option supplémentaire de 1,25 GW d'OpenAI représente un potentiel de croissance, pas un revenu garanti
Au-delà de la capacité engagée, OpenAI détient une option pour acheter 1,25 GW supplémentaires de capacité d'inférence Cerebras pour un déploiement jusqu'en 2030, ce qui pourrait porter la relation à jusqu'à 2 GW. Cette option pourrait considérablement élargir l'opportunité commerciale si OpenAI choisit de l'exercer, mais elle ne doit pas être traitée comme un revenu contractuel aujourd'hui. La future expansion dépendra probablement des performances, de la rentabilité, de la fiabilité du déploiement et des besoins infrastructurels plus larges d'OpenAI. Pour les actions Cerebras, la preuve qu'OpenAI prend une capacité supplémentaire pourrait renforcer les attentes en matière de demande à long terme, tandis que l'absence d'expansion ne signifierait pas en soi que l'accord existant a échoué.
La diversification des clients pourrait réduire la dépendance de CBRS à OpenAI
OpenAI peut rester un moteur de croissance majeur tandis que Cerebras élargit sa base de clients. L'entreprise a déjà révélé des partenariats avec AWS, AMD, Cognition, Lovable, CrowdStrike, Figma et d'autres clients professionnels, tandis que ses revenus provenant du cloud et des services ont atteint 126 millions de dollars au deuxième trimestre, en hausse de 281 % d'une année sur l'autre selon les normes GAAP. Étendre ces déploiements offrirait aux investisseurs un autre moyen d'évaluer si la demande pour l'inférence de Cerebras dépasse un seul grand client. Avec le temps, une diversification plus forte des revenus pourrait rendre CBRS moins sensible aux changements dans les décisions d'infrastructure d'OpenAI et fournir des preuves plus claires que Cerebras peut transformer sa technologie à l'échelle des plaquettes en une plateforme commerciale plus large.
🔥 Au-delà des titres : ce que KuCoin 5.0 signifie pour vous
Les actualités du marché évoluent rapidement — mais où vous agissez dessus compte tout autant. Ce octobre, KuCoin lance KuCoin 5.0, transformant KuCoin en une plateforme entièrement重构. Voici ce qui change réellement pour vous :
-
Un seul compte pour tout. Les anciennes plateformes répartissaient votre argent entre des comptes séparés « spot », « marge » et « futures » et s'attendaient à ce que vous compreniez pourquoi. Le compte unifié de KuCoin 5.0 élimine complètement cela — déposez une seule fois, et tout est simplement disponible (actuellement uniquement disponible pour les VIP).
-
Actions, indices et matières premières. KuCoin 5.0 s'étend au-delà du crypto vers les marchés mondiaux. Lorsque le crypto stagne et que les actions progressent (ou l'inverse), vous effectuez une rotation en quelques minutes au lieu d'ouvrir un compte de courtage et d'attendre des jours pour les voies monétaires.
-
Actifs du monde réel (RWA). Une exposition tokenisée à des actifs traditionnels comme les matières premières, directement dans votre compte crypto. L’un des segments à la croissance la plus rapide de la finance mondiale n’est plus réservé aux institutions — vous y accédez depuis le même solde que celui que vous utilisez pour trader.
-
Gagnez tout en apprenant. Pas prêt à trader ? KCUSD permet à vos stablecoins de générer des intérêts quotidiens, avec un auto-compound. La méthode la moins stressante pour faire travailler vos dépôts inactifs avec un rendement de 4 %.
-
Un assistant IA en langage simple. Posez des questions, obtenez du contexte sur le marché, comprenez ce que vous voyez — intégré à la plateforme, aucun jargon requis.
-
Une application qui ne submerge pas. Plus rapide, plus propre et cohérente — intuitive dès le premier toucher, sans besoin de tutoriel.
-
Sécurité que vous pouvez vérifier, et non simplement confier. Une entité européenne autorisée MiCAR, Proof of Reserves que vous pouvez vérifier vous-même, et une sécurité certifiée internationalement (SOC 2 Type II, ISO 27001:2022).
Créez votre compte en quelques minutes — et commencez sur la plateforme conçue pour où va la crypto, pas où elle en est venue.
Conclusion
La baisse de près de 20 % du cours de Cerebras reflète plus que le rapport OpenAI-Nvidia. Les déblocages d'actions, les déclarations de cessions par des insiders et l'incertitude concernant les charges de travail d'inférence futures ont également pesé sur CBRS, tandis que le partenariat plus large entre OpenAI et Cerebras reste en place. La question plus importante maintenant est de savoir si Cerebras peut transformer son architecture à l'échelle d'une galette en une croissance commerciale durable alors que Nvidia s'implante davantage dans l'inférence IA. À l'avenir, les investisseurs se concentreront probablement sur la croissance des revenus, les marges, le déploiement de capacité, la diversification des clients et toute extension du partenariat avec OpenAI. Ces facteurs devraient offrir une vision plus claire de la position à long terme de Cerebras dans la course aux puces IA que toute décision unique relative à un modèle ou à du matériel.
FAQ
Qu'est-ce que Cerebras Systems ?
Cerebras Systems est une entreprise américaine de calcul IA célèbre pour le développement de processeurs à échelle de galette conçus pour les charges de travail d'intelligence artificielle. Ses systèmes sont utilisés pour l'entraînement et l'inférence IA, l'entreprise mettant particulièrement l'accent sur la réduction de la latence impliquée dans la génération de réponses à partir de grands modèles IA.
Quel est le ticker action de Cerebras ?
Cerebras Systems est cotée sur le Nasdaq Global Select Market sous le ticker CBRS. L'entreprise a fait son entrée en bourse le 14 mai 2026, offrant aux investisseurs du marché public une exposition directe à l'un des concurrents émergents d'Nvidia dans l'infrastructure de calcul IA.
Quel a été le prix de l'IPO de Cerebras ?
Cerebras a fixé son offre publique initiale à 185 $ par action en mai 2026. L'offre terminée comprenait 34,5 millions d'actions de classe A et a généré environ 6,38 milliards de dollars de recettes brutes avant les remises de souscription et autres frais d'offre.
Qu'est-ce qui rend les puces Cerebras différentes des GPU traditionnels ?
Cerebras conçoit des processeurs autour d'une architecture à échelle de wafer, plutôt que de découper un wafer de silicium en plusieurs puces plus petites. Son design intègre une quantité très importante de calcul, de mémoire et de bande passante sur une seule puce, réduisant ainsi certains déplacements de données entre puces distinctes qui peuvent devenir un goulot d'étranglement dans les charges de travail AI de grande taille.
Pourquoi l'inférence IA à faible latence devient-elle importante ?
L'inférence à faible latence réduit le délai entre la demande d'un utilisateur et la réponse du modèle d'IA. Cela devient de plus en plus précieux pour les assistants de codage, l'IA vocale, les agents autonomes et d'autres applications où les utilisateurs ont besoin de réponses en quasi temps réel plutôt que d'attendre la fin de sorties de modèle longues.
L'accord entre OpenAI et Cerebras signifie-t-il que chaque modèle OpenAI fonctionnera sur Cerebras ?
Non. OpenAI a décrit sa stratégie d'infrastructure comme un portefeuille de différents systèmes informatiques adaptés à différentes charges de travail. Cerebras peut donc fournir une capacité d'inférence significative sans devenir le fournisseur exclusif de matériel pour chaque modèle, service ou niveau d'inférence d'OpenAI.
Avertissement : Cet article a uniquement une vocation informative et ne constitue pas un conseil en investissement. Les crypto-actifs peuvent être très volatils, et les conditions du marché, la liquidité des jetons ainsi que les évolutions des projets peuvent changer rapidement. Les lecteurs doivent mener leurs propres recherches et évaluer leur tolérance au risque avant de prendre toute décision financière.
Avertissement : Pour votre confort, cette page a été traduite à l'aide de la technologie IA. Pour obtenir les informations à la source, consultez la version anglaise originale.