

¿Qué son los ataques de distilación de modelos de IA? ¿Cómo está protegiendo Anthropic a Claude?
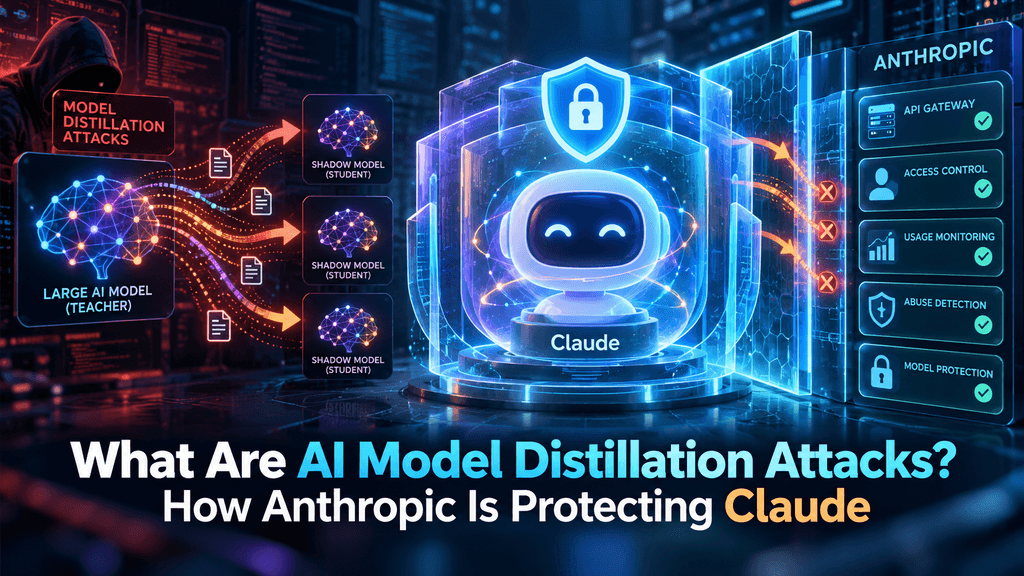
¿Podrían millones de dólares en investigación propietaria de inteligencia artificial ser desviados simplemente consultando una API pública? Los ataques de destilación de modelos permiten a entidades maliciosas consultar sistemáticamente sistemas de vanguardia como Claude para recolectar rutas de razonamiento de alta densidad, esquemas de funciones y lógica interna con el fin de entrenar sistemas rivales a una fracción del presupuesto estándar de desarrollo. Dentro de las redes descentralizadas de infraestructura física (DePIN) y los ecosistemas de criptomonedas, esta amenaza pone en peligro directamente los grupos descentralizados de cómputo, los mercados de inteligencia de peso abierto y la infraestructura de agentes autónomos. Al clonar capacidades de vanguardia, los adversarios socavan las redes tokenizadas y las herramientas de seguridad de contratos inteligentes sin financiar la investigación fundamental. Anthropic ha contrarrestado esta amenaza implementando sistemas de clasificación multinivel, agrupación automática de comportamientos, marcado de salida y ajustes dinámicos de inferencia. Este análisis examina los mecanismos de los ataques de destilación, sus graves consecuencias para los mercados descentralizados de IA y la arquitectura de defensa multicapa de Anthropic.
Principales conclusiones
-
Concepto principal: Los ataques de distilación de modelos explotan interfaces de programación de inferencia públicas para generar corpus sintéticos densos, permitiendo a los atacantes clonar el comportamiento de razonamiento propietario mientras evitan los gastos de investigación subyacentes.
-
Vulnerabilidades de Web3: Los ecosistemas descentralizados de IA, los bots autónomos en cadena y las redes de cómputo tokenizadas enfrentan riesgos estructurales graves cuando la destilación no autorizada comercializa capacidades únicas del modelo.
-
Medidas de contrarresto de Anthropic: Los mecanismos de defensa incluyen análisis de intención en tiempo real, telemetría conductual multiinquilino, protección del razonamiento contextual y marcado de agua criptográfico de tokens.
-
Explotación impulsada por Sybil: Las campañas de extracción utilizan anillos descentralizados de proxies, canales de pago virtuales rotativos y rieles de criptomonedas seudónimos para disfrazar la recolección a gran escala como tráfico de usuario orgánico.
-
Cambio en la economía del mercado: defensas sólidas eliminan atajos de imitación baratos, obligando a los desarrolladores en los sectores de tecnología tradicional y Web3 a invertir directamente en conjuntos de datos fundamentales auténticos e inferencias verificables.
¿Qué son los ataques de distilación de modelos de IA?
La mecánica: Cómo la extracción explota las interfaces del modelo
Los ataques de distilación de modelos aprovechan el acceso rutinario a la API para recolectar propiedad intelectual propietaria y duplicar capacidades de vanguardia. Crear modelos de vanguardia requiere cientos de millones de dólares en clústeres de hardware dedicados, pipelines sintéticos refinados y aprendizaje por refuerzo extenso. En contraste, un atacante inicia lotes de consultas automatizadas en dominios especializados, recopila las salidas completas del modelo objetivo y utiliza ese material estructurado para ajustar finamente arquitecturas más pequeñas con pesos abiertos. Este proceso evita las barreras de capital e ingeniería que definen el desarrollo moderno de aprendizaje automático.
El ataque tiene como objetivo interfaces estándar de generación de texto. Debido a que los sistemas avanzados están diseñados para proporcionar desgloses claros y exhaustivos de problemas al responder a solicitudes de programación o matemáticas, emiten inadvertidamente las señales instructivas exactas necesarias para entrenar modelos de imitación. El atacante envía desafíos lógicos complejos, registra los pasos intermedios de razonamiento y compila un corpus de entrenamiento denso. Cuando se ingiere en un modelo receptor más pequeño, este conjunto de datos curado permite que el sistema de imitación alcance puntajes de referencia mientras gasta menos del uno por ciento del capital original de entrenamiento. Debido a que las consultas se asemejan a solicitudes legítimas de desarrolladores, las defensas perimetrales tradicionales no reconocen la extracción.
Explotación de datos sintéticos y extracción de razonamiento
Extraer trazas intermedias de razonamiento acelera drásticamente el aprendizaje por imitación en comparación con el preentrenamiento no supervisado estándar. Los atacantes se centran en dominios de alto apalancamiento, como la auditoría automatizada de contratos inteligentes, la negociación teórica de juegos, el arbitraje en exchange descentralizados y las matemáticas simbólicas. Al enviar prompts diseñados para forzar un razonamiento paso a paso, el adversario convierte la plataforma objetivo en un generador automático de conjuntos de datos.
-
Recopilación mediante cadena de razonamiento: Extracción de pasos intermedios de resolución de problemas para distilar flujos cognitivos en redes de receptores no alineados o no autorizados.
-
Uso de herramientas y robo de esquemas: Captura de estructuras de llamadas a funciones, salidas JSON estructuradas y procedimientos de recuperación para entrenar agentes de ejecución autónomos.
-
Probing de límites de seguridad: evaluación sistemática de las barreras de protección para mapear filtros de moderación y entrenar modelos secundarios que eludan los protocolos de alineación estándar.
Topologías de ataque: campañas de extracción distribuidas
Las campañas modernas de distilación utilizan infraestructura distribuida en lugar de clientes aislados para evitar límites de tasa basados en volumen. Estas operaciones dependen de piscinas de proxies, perfiles de identidad rotativos y alojamiento multiinquilino para imitar patrones de interacción minorista diversos.
| Vector de ataque | Mecanismo de despliegue | Activo objetivo | Complejidad de la detección |
| Pools de consultas coordinadas | Botnets distribuidos que rotan claves de acceso de cliente | Pruebas matemáticas profundas, lógica de contrato inteligente | Alto |
| Solicitudes minoristas simuladas | Variantes paráfraseadas de los estándares académicos | Conocimiento especializado en dominios institucionales | Muy alto |
| Bucles de Agentes Autónomos | Cadenas de auto-prompting que ejecutan trabajos de múltiples pasos | Esquemas de ejecución, correcciones de errores en tiempo real | Extremo |
| Escaneos fronterizos adversarios | Pruebas automatizadas de límites de guardrail de perturbaciones | Límites de seguridad operativa, líneas base de moderación | Moderado |
Estas redes distribuidas frecuentemente utilizan redes de criptomonedas para mantener el anonimato. Los atacantes financian claves de acceso mediante proveedores de pagos virtuales financiados con activos descentralizados, rompiendo los enlaces de verificación de identidad utilizados por las plataformas de nube empresarial. En consecuencia, las campañas de extracción se mezclan con el crecimiento normal del tráfico en lugar de aparecer como operaciones coordinadas.
Intersección con Web3 y criptomoneda
Vectores de amenaza contra DePIN y cómputo descentralizado
La destilación de modelos presenta un desafío económico inmediato para las redes de inteligencia artificial Web3 y los sistemas de infraestructura física descentralizada. Las redes DePIN coordinan clústeres de hardware distribuido para entrenar, evaluar y alojar modelos mediante incentivos en tokens. Cuando los modelos alojados en nodos abiertos son raspados sistemáticamente mediante destilación no autorizada, el valor intrínseco que respalda los tokens de utilidad nativa se degrada.
Si el acceso a nodos del modelo descentralizado produce clones locales autohospedados, la demanda de staking nativo y tokens de utilidad disminuye. La destilación convierte en mercancía las salidas computacionales antes de que las redes puedan establecer ingresos constantes por tarifas. Por ejemplo, si un ecosistema gasta fondos de tesorería para construir un motor especializado de análisis de cadena de bloques, un adversario puede extraer esas capacidades de razonamiento en días, implementar un modelo idéntico en una red alternativa, reducir los precios y diluir la posición de mercado del proyecto original.
Vulnerabilidades en agentes de contratos inteligentes y seguridad en la cadena
Los agentes autónomos que utilizan modelos de vanguardia para la optimización de rendimiento, la gestión de liquidez y la evaluación de contratos inteligentes enfrentan una grave duplicación operativa. Los adversarios monitorean las actividades de los agentes para aislar las estrategias de ejecución, los parámetros de riesgo y los mecanismos de validación.
-
Replicación de estrategia: Los competidores clonan algoritmos de creación autónoma de mercado al capturar los marcos de decisión generados por agentes impulsados por la vanguardia.
-
Aceleración de explotación: Los modelos clonados entrenados con heurísticas de seguridad extraídas permiten a los adversarios realizar escaneos de vulnerabilidades fuera de línea, descubriendo fallos en contratos sin transmitir actividad en libros públicos.
-
Bucles de financiación Sybil: Entidades no reguladas utilizan monederos enfocados en la privacidad y herramientas financieras descentralizadas para financiar clústeres de raspado, evitando las verificaciones de conozca a su cliente.
Interrupción del staking en el aprendizaje automático descentralizado
La seguridad económica de las redes de AI stakeada se basa en la premisa de que generar inteligencia de alta calidad requiere un gasto sustancial de recursos. En un entorno de aprendizaje automático con prueba de stake, los operadores de nodos depositan garantías para garantizar salidas precisas y computacionalmente intensivas.
La destilación compromete este equilibrio de incentivos. Un operador malicioso puede destilar un modelo propietario en una arquitectura de imitación ligera, ejecutar esa copia en hardware de consumo económico y enviar sus salidas a la red. Dado que la imitación cumple con los criterios estándar de validación, el operador obtiene recompensas completas de validación mientras incurre en una fracción de los costos de cómputo legítimos. Esta dinámica penaliza a los operadores honestos que mantienen infraestructura empresarial dedicada, fomentando la centralización de la red y socavando la confianza en el protocolo descentralizado.
Cómo Anthropic protege a Claude
Clasificación dinámica de intención en dos etapas
Anthropic aplica un marco de clasificación en dos etapas para interceptar consultas de extracción antes de que generen datos de entrenamiento. En lugar de depender de listas negras de palabras clave simples, las solicitudes se analizan en dimensiones semánticas, sintácticas y estructurales.
La etapa inicial realiza un perfilado semántico estructural. El clasificador evalúa si una solicitud entrante presenta señales de generación programática de conjuntos de datos, como permutaciones repetitivas o estructuras de referencia académica, en lugar de uso orgánico por parte de desarrolladores. La segunda etapa monitorea en tiempo real la dinámica de emisión de tokens de salida para interceptar consultas diseñadas para extraer deliberaciones ocultas. Cuando se detecta una extracción de alta probabilidad, la plataforma activa ajustes dinámicos en las respuestas, proporcionando una respuesta directa mientras omite las trazas de razonamiento intermedio que los atacantes necesitan para el ajuste fino.
Telemetría conductual multiinquilino y agrupamiento
Para exponer anillos de clientes distribuidos, Anthropic correlaciona la telemetría conductual entre cuentas de usuario aparentemente independientes. Debido a que la destilación requiere volúmenes masivos de datos, las campañas de recolección generan correlaciones estadísticas detectables en toda la red.
Cuando cuentas dispares en diversos espacios de IP y métodos de pago demuestran ritmos conductuales paralelos, la plataforma marca la correlación. El motor de telemetría evalúa plantillas de sintaxis de solicitud coincidentes, solicitudes de token sincronizadas y exploraciones de dominio complementarias. Si miles de cuentas independientes consultan permutaciones de desafíos de programación idénticos en secuencias escalonadas, el sistema las atribuye a una operación coordinada. Anthropic entonces aplica ajustes coordinados de tasa, registro detallado y revocaciones simultáneas de acceso para desmantelar la red.
Protección de la ventana de contexto
Un método de destilación establecido implica la manipulación del contexto, donde los atacantes pegan los pasos anteriores de razonamiento del modelo de nuevo en prompts frescos para obligar a la divulgación continua de información técnica.
Anthropic eliminó esta vulnerabilidad al revisar los mecanismos de procesamiento de contexto. El sistema implementa un seguimiento estricto de la procedencia de todos los tokens dentro de la ventana de contexto, distinguiendo entre la entrada del usuario externo, el historial de generación previa y los elementos de razonamiento protegidos. Cuando un usuario inyecta trazas de razonamiento previamente generadas para forzar la divulgación sistemática, el modelo reconoce el patrón adversario y termina la ruta de ejecución, bloqueando el uso de ventanas de contexto largas como vectores de extracción.
Marcado de agua criptográfico y estadístico
Anthropic utiliza el marcado estadístico para incrustar patrones estructurales verificables dentro de las secuencias de salida, proporcionando evidencia matemática del origen sin comprometer la claridad, la fluidez o la precisión técnica.
La técnica fundamental utiliza ajustes de frecuencia de tokens pseudorrandómicos. El motor de generación prioriza sutilmente tokens sinónimos específicos según una clave criptográfica interna. Aunque la salida parece natural para los lectores humanos, el análisis estadístico de grandes conjuntos de datos generados por un modelo clon sospechoso revela si se entrenó con salidas de Claude. Esta atribución de procedencia proporciona evidencia accionable para presentar reclamaciones de propiedad intelectual, eliminar modelos no autorizados de repositorios abiertos e invalidar servicios ilegítimos en redes descentralizadas.
Medidas económicas
La defensa más resistente contra la distilación de modelos interrumpe los cálculos financieros del atacante. La distilación es viable solo cuando consultar una API es sustancialmente más barato que el desarrollo independiente del modelo. Anthropic alinea las defensas técnicas con penalizaciones económicas.
| Capa protectora | Enfoque operativo | Resultado estratégico |
| Clasificador de dos etapas | Análisis semántico en tiempo real | Neutraliza las indicaciones de extracción previas a la generación |
| Agrupación conductual | Correlación de patrones entre cuentas | Desmantela redes de bots de raspado distribuidas |
| Protección del contexto | Rastreo de la procedencia de los tokens | Evita la extracción por inyección de instrucciones |
| Marcas de agua estadísticas | Ajustes de frecuencia de tokens criptográficos | Proporciona atribución verificable de los datos robados |
Cuando los clasificadores de intención identifican un intento de extracción y cambian a salidas concisas, la plataforma procesa la solicitud a tarifas de facturación estándar. Además, cuando el mapeo conductual confirma un anillo de extracción distribuido, las cuentas asociadas se cierran y los saldos prefinanciados se forfeitan por violaciones del servicio. Cobrar por datos de entrenamiento no viables mientras se neutralizan cuentas operativas hace que la extracción a gran escala sea económicamente inviable.
Implicaciones estratégicas para los mercados de cripto y IA
Cambio en la economía del aprendizaje automático
La implementación de defensas efectivas de destilación altera la economía unitaria del desarrollo de IA en tanto la computación tradicional como los protocolos descentralizados. A medida que las plataformas de vanguardia restringen las fugas de entrenamiento sintético, construir modelos eficientes vuelve a exigir capacidad computacional real, innovación arquitectónica y conjuntos de datos verificados.
Esta transición acelera la consolidación de capital en protocolos de inteligencia descentralizada. Los equipos ya no pueden sostener propuestas de valor empaquetando salidas filtradas en envolturas abiertas. Las iniciativas descentralizadas deben invertir en investigación primaria, retroalimentación humana verificada criptográficamente e infraestructura dedicada. Los mercados de activos digitales reflejan este cambio, realocando capital lejos de envolturas derivadas hacia protocolos fundamentales que demuestren autenticidad comprobable en el entrenamiento y arquitecturas de modelo sostenibles.
Fortalecimiento de los ecosistemas de peso abierto
El límite entre la investigación de código abierto y la inteligencia propietaria está definido por cómo se gobierna la procedencia de los datos. Los modelos de peso abierto entrenados con conjuntos de datos públicos verificados siguen siendo esenciales para sistemas transparentes y descentralizados. Sin embargo, los sistemas que dependen de la destilación no autorizada enfrentan interrupciones repentinas debido a mitigaciones a nivel de plataforma y responsabilidades regulatorias.
Las organizaciones Web3 que combinan machine learning y cadenas de bloques deben construir tuberías de datos verificables. Implementar modelos que contengan marcas de agua detectables expone los protocolos descentralizados a riesgos operativos y legales, incluyendo la exclusión de importantes centros de liquidez e integraciones con finanzas descentralizadas institucionales. Los proyectos están adoptando marcos estrictos de auditoría de datos para confirmar que sus recursos de entrenamiento no infringen activos propiedad.
Inferencia verificable y pruebas de conocimiento cero
A medida que los riesgos de destilación y sustitución de modelos aumentan, los protocolos de criptomoneda están integrando mecanismos de inferencia verificable basados en aprendizaje automático de prueba de conocimiento cero (zkML). Las pruebas de conocimiento cero permiten que un nodo descentralizado demuestre matemáticamente que una salida de inferencia fue calculada por un modelo específico y auténtico sin revelar los parámetros subyacentes ni las entradas de prompt privadas.
Esta validación criptográfica asegura que los nodos ejecuten modelos auténticos en lugar de imitaciones ligeras y distiladas diseñadas para capturar recompensas de manera deshonesta. Al requerir pruebas criptográficas de ejecución, las redes descentralizadas garantizan que los usuarios reciban inteligencia auténtica. Mientras que zkML verifica la fidelidad de la ejecución en la cadena, las defensas de los proveedores de vanguardia protegen el desarrollo inicial del modelo, formando un límite de seguridad integrado para la emergente economía digital autónoma.
Conclusión
Los ataques de distilación de modelos de IA representan un vector de extracción calculado que apunta a la inteligencia propietaria, redes de cómputo descentralizadas y sistemas autónomos de Web3. Mediante la ejecución de campañas de consultas automatizadas y a gran escala, los adversarios intentan eludir los costos fundamentales de entrenamiento y reproducir capacidades de razonamiento de vanguardia con bajo costo. Anthropic aborda este desafío mediante una arquitectura de defensa integrada que combina clasificación dinámica de intención, agrupación conductual multiinquilino, aplicación de procedencia del contexto y marcado criptográfico de salida. Dentro de los sistemas DeFi y DePIN, donde la toma de decisiones autónoma exige inteligencia confiable e inalterada, estos sistemas defensivos preservan la sostenibilidad del protocolo y evitan la desvalorización de los tokens de incentivo computacional. A medida que el sector del aprendizaje automático evoluciona durante 2026, el enfoque operativo se centrará en proteger los pesos del modelo, garantizar inferencias verificables y certificar la procedencia de los datos que alimentan las redes de software autónomo.
🔥 Más allá de las noticias: qué significa KuCoin 5.0 para ti
Las noticias del mercado avanzan rápido — pero donde actúes sobre ellas importa igualmente. Este octubre, KuCoin lanza KuCoin 5.0, transformando KuCoin en una plataforma reconstruida. Aquí está lo que realmente cambia para ti:
-
Una cuenta para todo. Las plataformas antiguas dividían tu dinero entre cuentas separadas de "spot", "margin" y "futures" y esperaban que entendieras por qué. La Cuenta Unificada de KuCoin 5.0 elimina esto por completo: realiza un depósito una vez y todo está simplemente disponible (por ahora solo disponible para VIPs).
-
Acciones, índices y materias primas. KuCoin 5.0 se expande más allá del cripto hacia mercados globales. Cuando el cripto se mueve lateralmente y las acciones suben (o al revés), rotas en minutos en lugar de abrir una cuenta de corretaje y esperar días para que se activen los canales de moneda fiduciaria.
-
Activos del mundo real (RWA). Exposición tokenizada a activos tradicionales como materias primas, directamente en tu cuenta de cripto. Uno de los segmentos de más rápido crecimiento en las finanzas globales ya no está reservado para instituciones: tú lo accedes desde el mismo saldo con el que operas.
-
Gana mientras aprendes. ¿Aún no estás listo para operar? KCUSD permite que tus stablecoins generen intereses diarios con autocomposición. La forma menos estresante de hacer que tus depósitos inactivos trabajen para ti con un rendimiento del 4%.
-
Un asistente de IA en lenguaje sencillo. Haz preguntas, obtén contexto del mercado, entiende lo que estás viendo: integrado en la plataforma, sin necesidad de jerga.
-
Una aplicación que no abruma. Más rápida, más limpia y coherente: intuitiva desde el primer toque, no después de un tutorial.
-
Seguridad que puedes verificar, no solo confiar. Una entidad de la UE con licencia MiCAR, Proof of Reserves que puedes verificar tú mismo, y seguridad certificada internacionalmente (SOC 2 Type II, ISO 27001:2022).
Crea tu cuenta en minutos y comienza en la plataforma diseñada para adónde va el cripto, no adónde ha estado.
Preguntas frecuentes
¿Cuál es la diferencia técnica entre el ajuste fino del modelo y la distilación del modelo?
La afinación ajusta los parámetros internos de un modelo fundamental existente utilizando conjuntos de datos específicos para optimizar su rendimiento en tareas concretas. La destilación transfiere las capacidades y metodologías de razonamiento de un modelo maestro masivo a un modelo estudiante completamente separado, entrenando al estudiante con las salidas generadas por el maestro.
¿Pueden los adversarios eliminar las marcas de agua estadísticas en las salidas del modelo?
Las marcas de agua pueden diluirse mediante parafraseo secundario, dispersión semántica o combinación de salidas de múltiples arquitecturas distintas. Sin embargo, eliminar completamente las marcas de agua estadísticas de múltiples bits generalmente degrada la precisión del razonamiento y la estructura sintáctica, y las firmas matemáticas subyacentes siguen siendo detectables en grandes conjuntos de datos de entrenamiento.
¿Todos los formas de generación de datos sintéticos se clasifican como ataques de destilación?
No. La generación de datos sintéticos constituye un ataque de destilación solo cuando viola los términos de servicio vinculantes del proveedor de la API, elude controles de acceso o extrae intencionadamente trazas de razonamiento propietarias sin autorización para replicar capacidades comerciales en modelos rivales.
¿Cómo se relacionan las pruebas de conocimiento cero con la distilación de modelos en cadenas de bloques públicas?
El aprendizaje automático de conocimiento cero verifica que una salida fue generada por una arquitectura de modelo específica sin exponer los pesos del modelo ni las entradas privadas. Si bien confirma la integridad de la ejecución y previene que los operadores de nodo sustituyan secretamente clones distilados, no impide que un usuario autorizado utilice salidas verificadas para entrenar un modelo fuera de la cadena.
¿La destilación excesiva degrada el rendimiento de los modelos de imitación?
Sí. Los sistemas destilados entrenados exclusivamente en salidas sintéticas sufren frecuentemente de colapso del modelo y alucinaciones acumulativas. Sin base en corpora de entrenamiento primarios amplios y validación humana, los clones destilados tienen dificultades con espacios de problemas nuevos y fallan cuando se exponen a tareas complejas fuera de sus ejemplos de entrenamiento estrechos.
Descargo de responsabilidad: Este artículo tiene fines informativos únicamente y no constituye asesoría financiera ni de inversión. Las inversiones en criptomonedas conllevan un riesgo significativo. Siempre realiza tu propia investigación antes de operar.
Aviso: Esta página fue traducida utilizando tecnología de IA para tu conveniencia. Para obtener la información más precisa, consulta la versión original en inglés.