

O Que São Ataques de Distilação de Modelos de IA? Como a Anthropic Está Protegendo o Claude
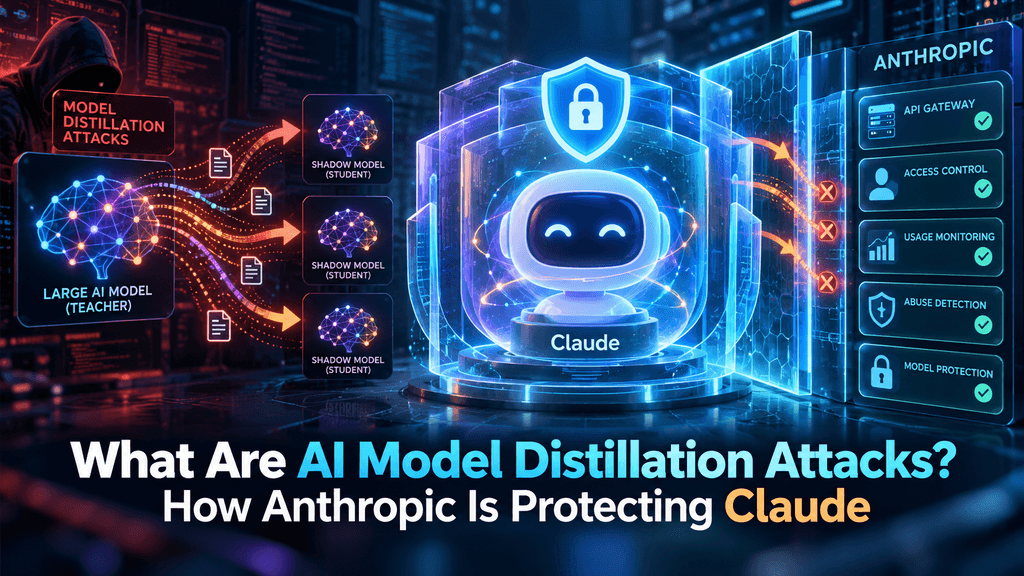
Milhões de dólares em pesquisa proprietária de inteligência artificial podem ser desviados simplesmente consultando uma API pública? Ataques de distilação de modelo permitem que entidades maliciosas consultem sistematicamente sistemas de ponta como o Claude para colher caminhos de raciocínio de alta densidade, esquemas de funções e lógica interna, treinando sistemas rivais com uma fração dos orçamentos padrão de desenvolvimento. Dentro das redes de infraestrutura física descentralizada (DePIN) e dos ecossistemas de criptomoedas, essa ameaça coloca em perigo diretamente pools de computação descentralizados, mercados de inteligência de peso aberto e infraestrutura de agentes autônomos. Ao clonar capacidades de ponta, adversários subvertem redes tokenizadas e ferramentas de segurança de contratos inteligentes sem financiar pesquisa fundamental. A Anthropic contrapôs essa ameaça implantando sistemas de classificação em múltiplas camadas, agrupamento comportamental automatizado, marca-d’água de saída e ajustes dinâmicos de inferência. Esta análise examina os mecanismos dos ataques de distilação, suas sérias ramificações para mercados descentralizados de IA e a arquitetura de defesa multicamada da Anthropic.
Principais destaques
-
Conceito principal: Ataques de distilação de modelo exploram interfaces de programação de inferência públicas para gerar corpora sintéticos densos, permitindo que atacantes clonem comportamentos de raciocínio proprietários enquanto contornam os custos de pesquisa subjacentes.
-
Vulnerabilidades do Web3: Ecossistemas descentralizados de IA, bots autônomos em cadeia e redes de computação tokenizadas enfrentam riscos estruturais graves quando a destilação não autorizada commoditiza capacidades únicas de modelos.
-
Medidas de contramedida da Anthropic: Mecanismos de defesa incluem análise de intenção em tempo real, telemetria comportamental multi-inquilino, proteção de raciocínio contextual e marca-d’água criptográfica de tokens.
-
Exploração impulsionada por Sybil: campanhas de extração utilizam anéis descentralizados de proxies, canais de pagamento virtuais rotativos e rotas de criptomoedas pseudônimas para disfarçar a coleta em larga escala como tráfego de usuário orgânico.
-
Mudança na economia de mercado: defesas robustas eliminam atalhos de imitação baratos, forçando desenvolvedores dos setores de tecnologia tradicional e Web3 a investirem diretamente em conjuntos de dados fundamentais autênticos e inferências verificáveis.
O que são ataques de distilação de modelos de IA?
Os Mecanismos: Como a Extração Explora Interfaces de Modelos
Ataques de distilação de modelo exploram o acesso rotineiro à API para colher propriedade intelectual proprietária e duplicar capacidades de ponta. Criar modelos de ponta exige centenas de milhões de dólares em clusters de hardware dedicados, pipelines sintéticos refinados e extenso aprendizado por reforço. Em contraste, um atacante inicia lotes de consultas automatizadas em domínios especializados, coleta as saídas abrangentes do modelo-alvo e usa esse material estruturado para ajustar finamente arquiteturas menores e de pesos abertos. Esse processo contorna as barreiras de capital e engenharia que definem o desenvolvimento moderno de aprendizado de máquina.
O ataque visa interfaces padrão de geração de texto. Como sistemas avançados são projetados para fornecer análises claras e detalhadas de problemas ao responder a prompts de programação ou matemática, eles acidentalmente emitem os sinais instrucionais exatos necessários para treinar modelos de imitação. O atacante envia desafios lógicos complexos, registra os passos intermediários de raciocínio e compila um corpus de treinamento denso. Quando ingerido por um modelo receptor menor, esse conjunto de dados curado permite que o sistema de imitação alcance pontuações de referência gastando menos de um por cento do capital original de treinamento. Como as consultas se assemelham a solicitações legítimas de desenvolvedores, as defesas perimetrais tradicionais não conseguem reconhecer a extração.
Exploração de Dados Sintéticos e Extração de Raciocínio
Extrair traços de raciocínio intermediários acelera drasticamente o aprendizado por imitação em comparação com o pré-treinamento não supervisionado padrão. Atacantes se concentram em domínios de alta alavancagem, como auditoria automatizada de contrato inteligente, negociação teórica de jogos, arbitragem em exchange descentralizada e matemática simbólica. Ao enviar prompts projetados para forçar lógica passo a passo, o adversário converte a plataforma-alvo em um gerador automático de conjunto de dados.
-
Coleta por Cadeia de Raciocínio: Coleta de etapas intermediárias de resolução de problemas para distilar fluxos cognitivos em redes de destinatários não alinhados ou não autorizados.
-
Uso de ferramentas e roubo de esquema: Captura de estruturas de chamadas de função, saídas JSON estruturadas e procedimentos de recuperação para treinar agentes de execução autônomos.
-
Probing de Limite de Segurança: Avaliação sistemática de barreiras para mapear filtros de moderação e treinar modelos secundários que contornem protocolos de alinhamento padrão.
Topologias de Ataque: Campanhas de Extração Distribuída
Campanhas modernas de distilação utilizam infraestrutura distribuída em vez de clientes isolados para evitar limites de taxa baseados em volume. Essas operações dependem de pools de proxies, perfis de identidade rotativos e hospedagem multi-inquilino para imitar padrões de interação varejista diversificados.
| Vetor de Ataque | Mecanismo de Implantação | Ativo de destino | Complexidade da Detecção |
| Pools de Consultas Coordenadas | Botnets distribuídos rotacionando chaves de acesso dos clientes | Provas matemáticas aprofundadas, lógica de contrato inteligente | Alto |
| Promptes Varejistas Simulados | Variantes paráfraseadas de benchmarks acadêmicos padrão | Conhecimento especializado em domínio institucional | Muito Alto |
| Laços de Agente Autônomo | Pipeline de autoaprimoramento executando tarefas em múltiplos passos | Esquemas de execução, correções de erros em tempo real | Extremo |
| Varreduras de Fronteira Adversárias | Teste automatizado de limites de proteção de perturbações | Limites de segurança operacional, linhas de base de moderação | Moderado |
Essas redes distribuídas frequentemente utilizam redes de criptomoedas para manter o anonimato. Os atacantes financiam chaves de acesso usando provedores de pagamento virtual financiados por ativos descentralizados, rompendo as ligações de verificação de identidade utilizadas por plataformas de nuvem corporativas. Consequentemente, campanhas de extração se misturam ao crescimento normal do tráfego em vez de aparecer como operações coordenadas.
Intersetion com Web3 e criptomoeda
Vetores de Ameaça Contra DePIN e Computação Descentralizada
A dessilação de modelos apresenta um desafio econômico imediato para redes de inteligência artificial Web3 e sistemas de infraestrutura física descentralizada. Redes DePIN coordenam clusters de hardware distribuídos para treinar, avaliar e hospedar modelos por meio de incentivos em tokens. Quando modelos hospedados em nós abertos são sistematicamente extraídos por meio de dessilação não autorizada, o valor intrínseco que sustenta os tokens de utilidade nativa se deteriora.
Se o acesso aos nós do modelo descentralizado produz clones locais auto-hospedados, a demanda por staking nativo e tokens de utilidade diminui. A destilação transforma em commodity saídas computacionais antes que as redes possam estabelecer receita de taxas estável. Por exemplo, se um ecossistema gastar fundos do tesouro para construir um motor especializado de análise de blockchain, um adversário pode extrair essas capacidades de raciocínio em poucos dias, implantar um modelo idêntico em uma rede alternativa, reduzir os preços e diluir a posição de mercado do projeto original.
Vulnerabilidades em Agentes de Contratos Inteligentes e Segurança On-Chain
Agentes autônomos que utilizam modelos de ponta para otimização de rendimento, gestão de liquidez e avaliação de contratos inteligentes enfrentam severa duplicação operacional. Adversários monitoram as atividades dos agentes para isolar estratégias de execução, parâmetros de risco e mecanismos de validação.
-
Replicação de Estratégia: Concorrentes clonam algoritmos autônomos de market-making capturando os quadros de decisão gerados por agentes impulsionados pela fronteira.
-
Aceleração de Exploração: Modelos clonados treinados em heurísticas de segurança extraídas permitem que adversários realizem varreduras de vulnerabilidades offline, descobrindo falhas em contratos sem transmitir atividade em livros públicos.
-
Laços de financiamento Sybil: entidades não regulamentadas utilizam carteiras focadas em privacidade e ferramentas financeiras descentralizadas para financiar clusters de raspagem, contornando verificações de know-your-customer.
Interrupção de Staking em Aprendizado de Máquina Descentralizado
A segurança econômica das redes de IA com staking baseia-se na premissa de que gerar inteligência de alta qualidade exige um gasto substancial de recursos. Em um ambiente de aprendizado de máquina com proof-of-stake, os operadores de nodes depositam garantias para assegurar saídas precisas e computacionalmente intensivas.
A destilação compromete esse equilíbrio de incentivos. Um operador malicioso pode destilar um modelo proprietário em uma arquitetura leve de imitação, executar essa cópia em hardware de consumo barato e enviar suas saídas para a rede. Como a imitação atende aos critérios padrão de validação, o operador recebe recompensas completas de validação, incorrendo em uma fração dos custos de computação legítimos. Essa dinâmica penaliza operadores honestos que mantêm infraestrutura empresarial dedicada, incentivando a centralização da rede e minando a confiança no protocolo descentralizado.
Como a Anthropic protege o Claude
Classificação Dinâmica de Intenção em Dois Estágios
A Anthropic aplica um framework de classificação em duas etapas para interceptar consultas de extração antes que elas gerem dados de treinamento. Em vez de depender de listas negras simples de palavras-chave, as requisições são analisadas em dimensões semânticas, sintáticas e estruturais.
A fase inicial realiza o perfilamento semântico estrutural. O classificador avalia se um prompt entrante apresenta marcas de geração programática de conjunto de dados—como permutações repetitivas ou estruturas de referência acadêmica—em vez de uso orgânico por desenvolvedores. A segunda fase monitora dinamicamente a emissão de tokens de saída em tempo real para interceptar consultas projetadas para extrair deliberações ocultas. Quando é detectada uma extração de alta probabilidade, a plataforma aciona ajustes dinâmicos na resposta, fornecendo uma resposta direta enquanto oculta as trilhas de raciocínio intermediárias que os atacantes precisam para ajuste fino.
Telemetria Comportamental e Agrupamento Multiinquilino
Para expor anéis de clientes distribuídos, a Anthropic correlaciona telemetria comportamental entre contas de usuários aparentemente independentes. Como a dessaturação exige volumes imensos de dados, campanhas de coleta geram correlações estatísticas detectáveis na rede.
Quando contas distintas em diversos espaços de IP e formas de pagamento demonstram ritmos comportamentais paralelos, a plataforma sinaliza a correlação. O mecanismo de telemetria avalia modelos de sintaxe de prompt correspondentes, solicitações de token sincronizadas e explorações de domínio complementares. Se milhares de contas independentes consultarem permutações de desafios de programação idênticos em sequências escalonadas, o sistema os atribui a uma operação coordenada. A Anthropic aplica então ajustes coordenados de taxa, registro detalhado e revogações simultâneas de acesso para desmantelar a rede.
Proteção da Janela de Contexto
Um método estabelecido de distilação envolve manipulação de contexto, onde atacantes colam etapas anteriores de raciocínio do modelo de volta em prompts novos para forçar a divulgação contínua de informações técnicas.
A Anthropic eliminou essa vulnerabilidade revisando os mecanismos de processamento de contexto. O sistema implementa rastreamento rigoroso de proveniência para todos os tokens dentro da janela de contexto, distinguindo entre entrada do usuário externo, histórico de geração anterior e elementos de raciocínio protegidos. Quando um usuário injeta traços de raciocínio previamente gerados para forçar a divulgação sistemática, o modelo reconhece o padrão adversário e encerra o caminho de execução, bloqueando o uso das janelas de contexto longo como vetores de extração.
Marcação d'água criptográfica e estatística de saída
A Anthropic utiliza marcação estatística para incorporar padrões estruturais verificáveis dentro das sequências de saída, fornecendo evidência matemática de origem sem comprometer a clareza, fluidez ou precisão técnica.
A técnica fundamental utiliza ajustes de frequência de tokens pseudorrandômicos. O mecanismo de geração prioriza sutilmente tokens sinônimos específicos com base em uma chave criptográfica interna. Embora a saída pareça natural para leitores humanos, a análise estatística de grandes conjuntos de dados gerados por um modelo clonado suspeito revela se foi treinado com saídas do Claude. Essa atribuição de proveniência fornece evidências concretas para perseguir reivindicações de propriedade intelectual, remover modelos não autorizados de repositórios abertos e invalidar serviços ilegítimos em redes descentralizadas.
Medidas Econômicas
A defesa mais resistente contra a distilação de modelo interrompe os cálculos financeiros do atacante. A distilação é viável apenas quando consultar uma API é substancialmente mais barato do que o desenvolvimento independente do modelo. A Anthropic alinha defesas técnicas com penalidades econômicas.
| Camada Protetora | Foco Operacional | Resultado Estratégico |
| Classificador em Duas Etapas | Análise semântica em tempo real | Neutraliza prompts de extração pré-geração |
| Agrupamento Comportamental | Correlação de padrões entre contas | Desmonta botnets de raspagem distribuídas |
| Proteção de Contexto | Rastreamento de proveniência de tokens | Impede a extração por injeção de prompt |
| Marcas D'água Estatísticas | Ajustes de frequência de token criptográfico | Fornece atribuição verificável de dados roubados |
Quando classificadores de intenção identificam uma tentativa de extração e passam para saídas concisas, a plataforma processa a solicitação às taxas de cobrança padrão. Além disso, quando a digitalização comportamental confirma um anel distribuído de extração, as contas associadas são encerradas e os saldos pré-financiados são forfeitados por violação dos termos de serviço. Cobrar por dados de treinamento não viáveis enquanto neutraliza contas operacionais torna a extração em larga escala economicamente inviável.
Implicações estratégicas para os mercados de cripto e IA
Mudanças na Economia do Aprendizado de Máquina
A implementação de defesas eficazes de distilação altera a economia unitária do desenvolvimento de IA em ambas as plataformas tradicionais e descentralizadas. À medida que plataformas de ponta restringem vazamentos de treinamento sintético, construir modelos eficientes exige novamente capacidade computacional real, inovação arquitetônica e conjuntos de dados verificados.
Essa transição acelera a consolidação de capital em protocolos de inteligência descentralizada. As equipes não podem mais sustentar propostas de valor empacotando saídas filtradas em wrappers abertos. Iniciativas descentralizadas devem investir em pesquisa primária, feedback humano criptograficamente verificado e infraestrutura dedicada. Os mercados de ativos digitais refletem essa mudança, realocando capital de wrappers derivados em direção a protocolos fundamentais que demonstram autenticidade comprovada do treinamento e arquiteturas de modelo sustentáveis.
Fortalecimento dos ecossistemas de peso aberto
A fronteira entre pesquisa de código aberto e inteligência proprietária é definida pela forma como a proveniência dos dados é governada. Modelos de peso aberto treinados em conjuntos de dados públicos verificados permanecem essenciais para sistemas transparentes e descentralizados. No entanto, sistemas que dependem de distilação não autorizada enfrentam interrupções súbitas devido a mitigações ao nível da plataforma e responsabilidades regulatórias.
Organizações Web3 que combinam machine learning e infraestruturas de blockchain devem construir pipelines de dados verificáveis. A implantação de modelos contendo marcas d'água detectáveis expõe protocolos descentralizados a riscos operacionais e legais, incluindo exclusão de principais centros de liquidez e integrações com finanças descentralizadas institucionais. Projetos estão adotando frameworks rigorosos de auditoria de dados para confirmar que seus recursos de treinamento não violam ativos proprietários.
Inferência Verificável e Provas de Conhecimento Zero
À medida que os riscos de distilação e substituição de modelo aumentam, os protocolos de criptomoeda estão integrando mecanismos de inferência verificável baseados em aprendizado de máquina de prova de conhecimento zero (zkML). As provas de conhecimento zero permitem que um node descentralizado matematicamente prove que uma saída de inferência foi calculada por um modelo específico e autêntico, sem revelar os parâmetros subjacentes ou entradas de prompt privadas.
Essa validação criptográfica garante que os nodes executem modelos genuínos, e não imitações leves e distiladas projetadas para capturar recompensas de forma desonesta. Ao exigir provas criptográficas de execução, redes descentralizadas garantem que os usuários recebam inteligência autêntica. Enquanto o zkML verifica a fidelidade da execução na cadeia, as defesas dos provedores de ponta protegem o desenvolvimento inicial do modelo, formando um limite de segurança integrado para a emergente economia digital autônoma.
Conclusão
Ataques de distilação de modelos de IA representam um vetor de extração calculado que visa inteligência proprietária, redes de computação descentralizadas e sistemas autônomos do Web3. Ao executar campanhas automatizadas de consultas em larga escala, adversários tentam contornar custos fundamentais de treinamento e reproduzir capacidades de raciocínio de ponta com baixo custo. A Anthropic aborda esse desafio por meio de uma arquitetura de defesa integrada que combina classificação dinâmica de intenção, agrupamento comportamental multi-inquilino, aplicação de proveniência de contexto e marca-d’água criptográfica de saída. Dentro de sistemas DeFi e DePIN, onde a tomada de decisão autônoma exige inteligência confiável e inalterada, esses sistemas defensivos preservam a sustentabilidade do protocolo e impedem a desvalorização dos tokens de incentivo computacional. À medida que o setor de aprendizado de máquina se desenvolve ao longo de 2026, o foco operacional estará centrado em proteger pesos de modelos, garantir inferência verificável e certificar a proveniência dos dados que alimentam redes de software autônomo.
🔥 Além das manchetes: O que o KuCoin 5.0 significa para você
As notícias do mercado se movem rápido — mas onde você atua sobre elas importa tanto quanto. Este outono, a KuCoin lança a KuCoin 5.0, transformando a KuCoin em uma plataforma reconstruída. Aqui está o que realmente muda para você:
-
Uma conta para tudo. Plataformas antigas dividiam seu dinheiro entre contas separadas de "spot", "margin" e "futures" e esperavam que você entendesse por quê. A Conta Unificada do KuCoin 5.0 elimina isso completamente — faça um único depósito e tudo estará simplesmente disponível (por enquanto, disponível apenas para VIPs).
-
Ações, índices e commodities. O KuCoin 5.0 se expande além do cripto para mercados globais. Quando o cripto oscila lateralmente e as ações sobem (ou o contrário), você faz a rotação em minutos, em vez de abrir uma conta na corretora e esperar dias pelas vias de moeda fiduciária.
-
Ativos do mundo real (RWA). Exposição tokenizada a ativos tradicionais, como commodities, diretamente na sua conta de cripto. Um dos segmentos de mais rápido crescimento na finança global já não é mais reservado para instituições — você acessa-o a partir do mesmo saldo que usa para negociar.
-
Ganhe enquanto aprende. Não está pronto para negociar? KCUSD permite que suas stablecoins ganhem juros diários com composição automática. A maneira menos estressante de colocar seu depósito ocioso para trabalhar com um rendimento de 4%.
-
Um assistente de IA em linguagem simples. Faça perguntas, obtenha contexto de mercado, entenda o que está vendo — integrado à plataforma, sem necessidade de jargões.
-
Um aplicativo que não sobrecarrega. Mais rápido, mais limpo e consistente — intuitivo desde o primeiro toque, não após um tutorial.
-
Segurança que você pode verificar, não apenas confiar. Uma entidade da UE com licença MiCAR, Proof of Reserves que você pode verificar por si mesmo, e segurança certificada internacionalmente (SOC 2 Type II, ISO 27001:2022).
Crie sua conta em minutos — e comece na plataforma construída para onde o cripto está indo, não para onde já esteve.
Perguntas frequentes
Qual é a diferença técnica entre o ajuste fino do modelo e a distilação do modelo?
O ajuste fino ajusta os parâmetros internos de um modelo fundamental existente usando conjuntos de dados direcionados para otimizar seu desempenho para tarefas específicas. A distilação transfere as capacidades e metodologias de raciocínio de um modelo professor massivo para um modelo aluno totalmente separado, treinando o aluno com as saídas produzidas pelo professor.
É possível remover marcas-d’água estatísticas nas saídas do modelo por adversários?
Marcas-d’água podem ser diluídas por parafraseamento secundário, embaralhamento semântico ou combinação de saídas de múltiplas arquiteturas distintas. No entanto, remover completamente marcas-d’água estatísticas de múltiplos bits geralmente degrada a precisão do raciocínio e a estrutura sintática, e as assinaturas matemáticas subjacentes permanecem detectáveis em grandes conjuntos de dados de treinamento.
Todos os tipos de geração de dados sintéticos são classificados como ataques de destilação?
Não. A geração de dados sintéticos constitui um ataque de dissolução apenas quando viola os termos de serviço vinculativos do provedor da API, contorna controles de acesso ou extrai intencionalmente traços de raciocínio proprietários sem autorização para replicar capacidades comerciais em modelos concorrentes.
Como as provas de conhecimento zero se relacionam com a distilação de modelos em blockchains públicas?
O aprendizado de máquina de conhecimento zero verifica que uma saída foi gerada por uma arquitetura de modelo específica sem expor os pesos do modelo ou entradas privadas. Enquanto confirma a integridade da execução e impede que operadores de node substituam secretamente clones distilados, não impede um usuário autorizado de usar saídas verificadas para treinar um modelo fora da cadeia.
A destilação excessiva degrada o desempenho dos modelos de imitação?
Sim. Sistemas destilados treinados exclusivamente em saídas sintéticas frequentemente sofrem com colapso do modelo e alucinações cumulativas. Sem base em grandes corpora de treinamento primários e validação humana, clones destilados enfrentam dificuldades com espaços de problemas novos e falham quando expostos a tarefas complexas fora de seus exemplos de treinamento restritos.
Disclaimer: Este artigo é apenas para fins informativos e não constitui aconselhamento financeiro ou de investimento. Investimentos em criptomoedas apresentam risco significativo. Sempre realize sua própria pesquisa antes de negociar.
Aviso legal: Esta página foi traduzida usando tecnologia de IA para sua conveniência. Para informações mais precisas, consulte a versão original em inglês.